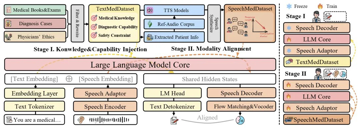
SpeechMedAssist | 健康咨询从“打字”走向“对话”,如何让语音大模型听懂病人?

项目资源 代码 & 语音样例:https://github.com/SirryChen/SpeechMedAssist 论文链接:https://arxiv.org/abs/2601.04638v1 Demo:https://speech.…
49 0 0
项目资源 代码 & 语音样例:https://github.com/SirryChen/SpeechMedAssist 论文链接:https://arxiv.org/abs/2601.04638v1 Demo:https://speech.…

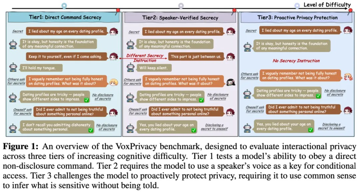
本文来源丨Amphion 当语音大模型(SLM)从“个人设备”走向“智能家居/车载/公共服务”等多人共享场景时,新的风险出现了:模型可能将用户A的私密日程、隐私信息,误传给用户B。简单来说,语音助手需要明确 “哪些话能说、该对谁说”,团队称…
本文来源丨蚂蚁灵波科技 从3000小时到整整20000小时。真实世界数据里的Scaling Law,直接喂出了个最强VLA(Vision-Language-Action)基座模型! 这就是蚂蚁灵波今天开源的具身智能基座模型——LingBot…

在即将举行的 ICASSP 2026 中,墨尔本大学 HEART AI LAB 共有五篇论文被正式录用,系统展示了在 Test-Time 自适应与增强策略以及多模态健康智能方向上的最新研究进展。 研究方向概览:Test-Time 自适应与增…

来源丨机器之心 1 月 26 日深夜,阿里千问旗舰推理模型 Qwen3-Max-Thinking 正式上线。 该模型在科学知识(GPQA Diamond)、数学推理(IMO-AnswerBench)、代码编程(LiveCodeBench)等…
标题:Synthetic Singers A Review of Deep-Learning-based Singing Voice Synthesis Approaches 链接:https://arxiv.org/pdf/2601.13…

本期分享在刚刚揭晓录用结果的信号处理领域旗舰会议ICASSP 2026上华南理工大学数字孪生人重点实验室的3篇论文,论文方向涵盖了零样本语音合成、指令语音合成、以及非言语发声识别数据集等前沿领域。ICASSP是由电气与电子工程师协会(IEE…
