

声浪

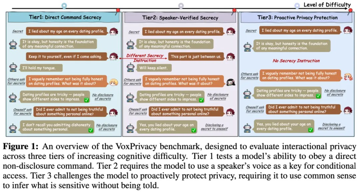
VoxPrivacy发布: 首个面向语音大模型的交互隐私评测基准

本文来源丨Amphion 当语音大模型(SLM)从“个人设备”走向“智能家居/车载/公共服务”等多人共享场景时,新的风险出现了:模型可能将用户A的私密日程、隐私信息,误传给用户B。简单来说,语音助手需要明确 “哪些话能说、该对谁说”,团队称…
52 0 0
蚂蚁开源最大具身智能基座模型Lingbot-VLA,20000小时真机数据、性能吊打英伟达GR00T和π0.5
本文来源丨蚂蚁灵波科技 从3000小时到整整20000小时。真实世界数据里的Scaling Law,直接喂出了个最强VLA(Vision-Language-Action)基座模型! 这就是蚂蚁灵波今天开源的具身智能基座模型——LingBot…
60 0 0

ICASSP 2026|墨尔本大学 HEART AI LAB 5篇录用论文分享
在即将举行的 ICASSP 2026 中,墨尔本大学 HEART AI LAB 共有五篇论文被正式录用,系统展示了在 Test-Time 自适应与增强策略以及多模态健康智能方向上的最新研究进展。 研究方向概览:Test-Time 自适应与增…
33 0 0

性能比肩Gemini 3 Pro!昨晚,阿里千问最强模型来了
来源丨机器之心 1 月 26 日深夜,阿里千问旗舰推理模型 Qwen3-Max-Thinking 正式上线。 该模型在科学知识(GPQA Diamond)、数学推理(IMO-AnswerBench)、代码编程(LiveCodeBench)等…
48 0 0
基于深度学习的歌声合成方法综述
标题:Synthetic Singers A Review of Deep-Learning-based Singing Voice Synthesis Approaches 链接:https://arxiv.org/pdf/2601.13…
42 0 0

ICASSP 2026丨华工数字孪生人重点实验室3篇录用论文分享
本期分享在刚刚揭晓录用结果的信号处理领域旗舰会议ICASSP 2026上华南理工大学数字孪生人重点实验室的3篇论文,论文方向涵盖了零样本语音合成、指令语音合成、以及非言语发声识别数据集等前沿领域。ICASSP是由电气与电子工程师协会(IEE…
40 0 0

IDEA研究院开源LEMAS:15万小时多语言数据集与两大生成模型,解决多语言语音生成痛点
标题: LEMAS: A 150K-Hour Large-scale Extensible Multilingual Audio Suite with Generative Speech Models 链接: https://arxiv.o…
48 0 0