 oldpan博客
数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已
首先使用最多的就是让纯净语音和带噪语音按照不同信噪比进行混合,这样就可以得到丰富的带噪语音,一般采用随机数生成随机的信噪比,信噪比的范围可以根据自己的使用场景进行设定。
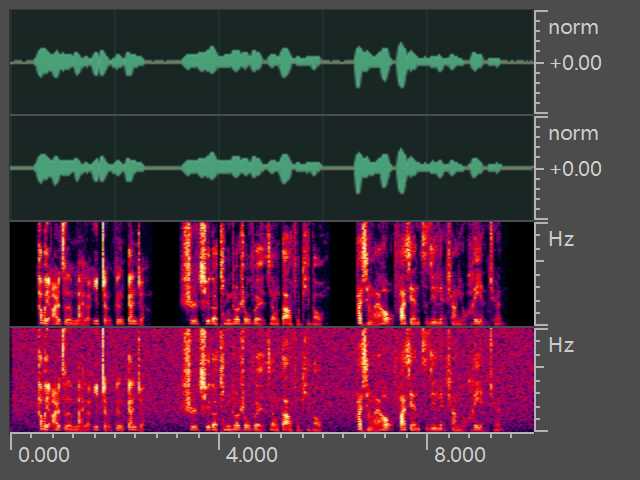
SpecTransform
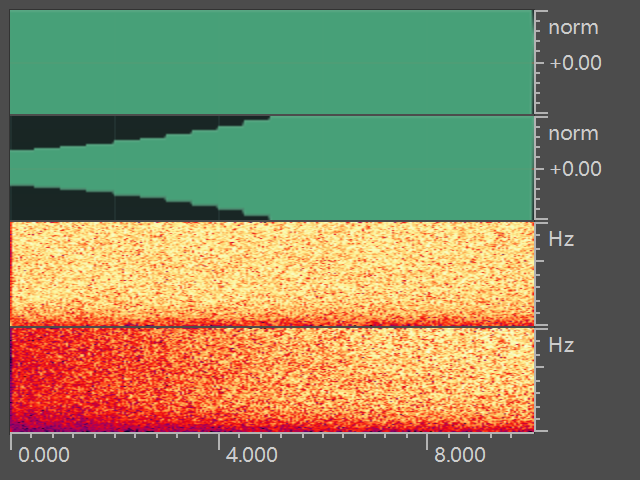
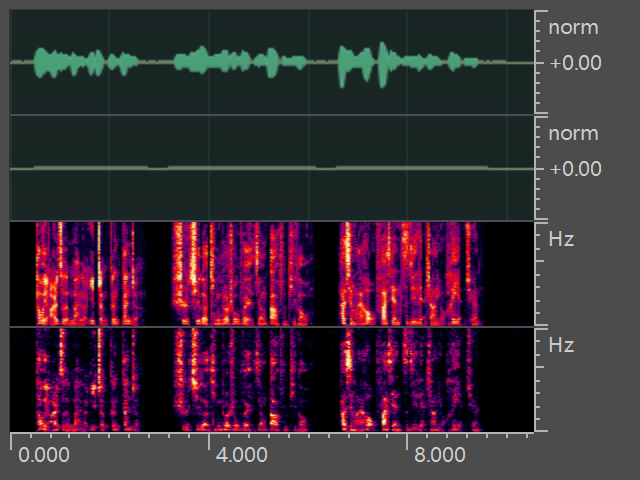
在RNNoise论文中,作者提出使用二阶的IIR滤波器分别对语音信号和噪声信号进行处理,从而丰富语音频谱特性。
VolTransform
FilterTransform
我们知道有些设备会对输入信号进行EQ处理,从而使得声音具有一定的偏向性,这里可以使用滤波器进行类似的数据扩增。
当声音大小超过输入设备比特所能表示的最大范围后就会发生削顶,这种也是现实生活中常见的一种情况。
ReverbTransform
为了模拟不同的使用场景,可以通过RIR去模拟不同的房间对应的不同的混响时间。
BreakTransform
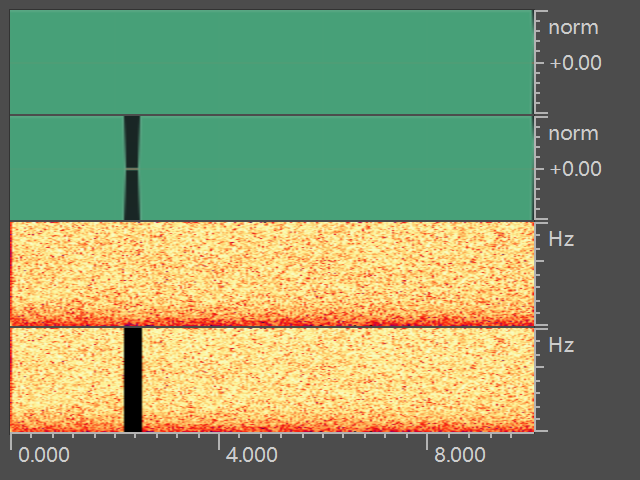
在网络通话过程中丢包是很常见的事情,我们可以通过时间轴上的mask来模拟语音帧不连续的过程。
Conclusion
本文相关代码(点文末阅读原文直接访问):
https://github.com/Ryuk17