从单模态迈向下一代多模态生成:港科大提出Talker-T2AV,将 TTS 拓展到音视频生成

近日,HKUST Audio 团队推出新一代联合音视频生成模型 Talker-T2AV。该模型面向talking head 场景,将传统 TTS 从单一语音生成进一步拓展到 文本到音频+视频联合生成,能够同时生成自然语音与同步的人脸运动,为…
33 0 0

近日,HKUST Audio 团队推出新一代联合音视频生成模型 Talker-T2AV。该模型面向talking head 场景,将传统 TTS 从单一语音生成进一步拓展到 文本到音频+视频联合生成,能够同时生成自然语音与同步的人脸运动,为…

本期分享中国科学技术大学语音及语言信息处理国家工程研究中心研究团队近期发表在IEEE Transactions on Audio, Speech and Language Processing期刊上的2篇关于超低码率语音编解码器的研究。 0…


近日,Soul AI Lab与西北工业大学音频语音与语言处理研究组、Moonstep AI,开源了端到端多人对话转录模型SoulX-Transcriber。 作为一款面向长音频、多说话人场景设计的语音理解模型,SoulX-Transcrib…
来源丨AI音频时代、Renee 创业随笔 近日,ElevenLabs 发布了新一代音乐模型 Music v2,目前已经可以在 ElevenMusic 和 ElevenCreative 中使用。 Stable Audio 3.0刚刚升级后(S…
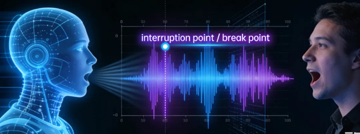
在自然的人机对话中,“系统能否被打断”以及“何时应停止发言并转而倾听用户”是决定交互自然性的关键问题。理想的语音对话系统(Spoken Dialogue System, SDS)不应只是机械地遵循“你一句、我一句”的轮替模式,而应像人与人交…

近日,清华大学自然语言处理与社会人文计算实验室与面壁智能、OpenBMB 开源社区正式发布ForgeTrain——全球首个完全由 AI 编写、零人类代码介入的生产级大模型训练框架。 它不是一个实验原型,而是一套可以直接投入生产、创造价值的“…

论文链接:https://arxiv.org/abs/2605.27258 项目主页:https://amapvoice.github.io/PilotTTS/ GitHub Repo:https://github