
 新一代Kaldi
1. 背景
几周前,我们已经在公众号上推了一篇文章《低时延 RNN-T 训练 》,介绍了如何在 RNN-T 流式模型上应用时延正则,以及在 Conformer 和 LSTM 上的实验结果。
本期公众号重点带大家回顾下具体的思路,以及如何类似地在 CTC 流式模型上应用时延正则。
有些内容可能有所重复,大家可适当跳过,小编也不会太桑心。
2. Delay penalty for RNN-T
标准 RNN-T
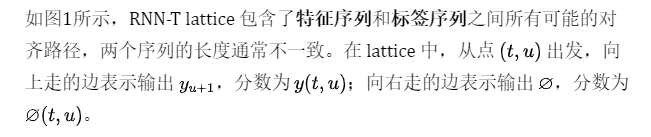
此处我们提及的 lattice 边上的分数,无特殊说明情况下,都是 log-probability。
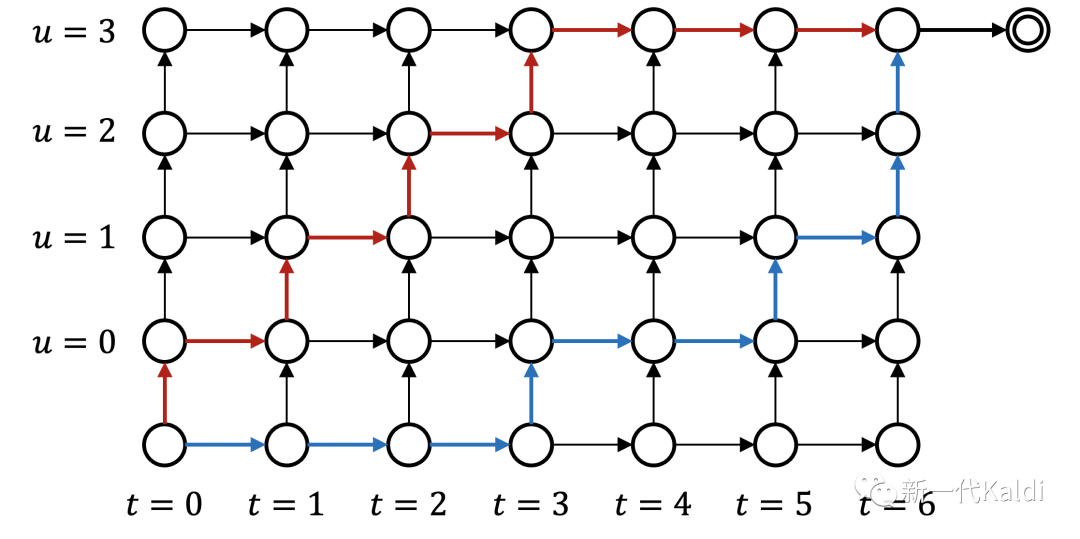
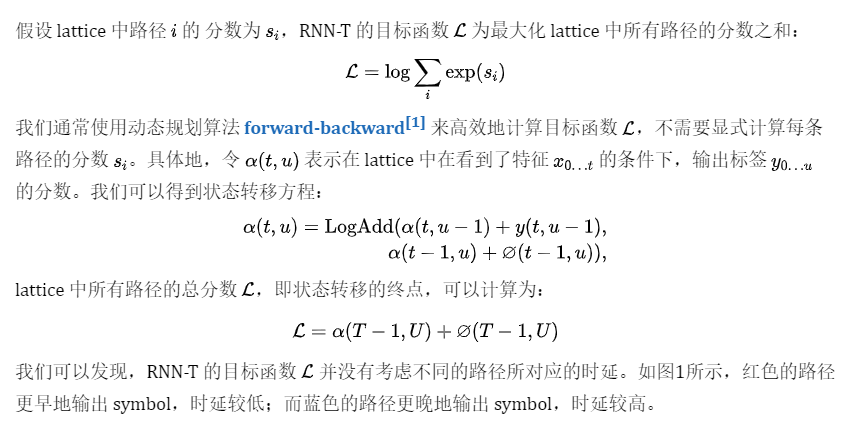
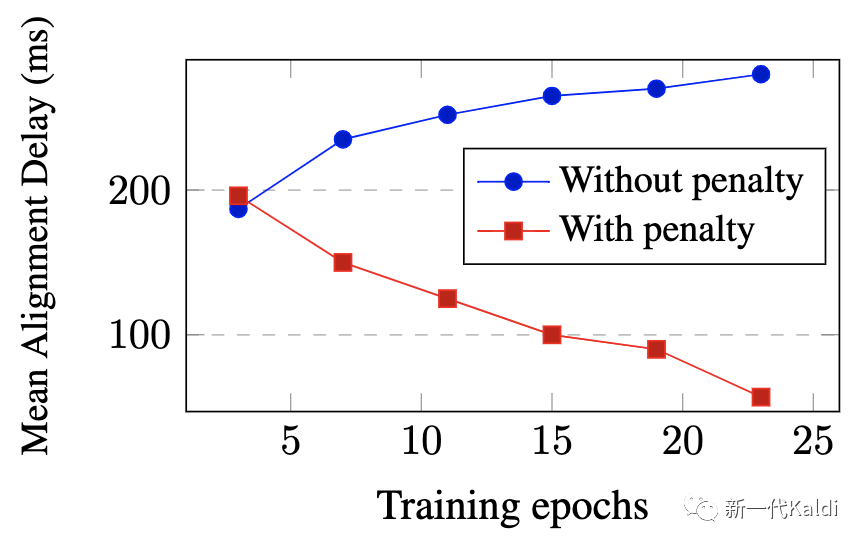
与非流式模型不同,流式模型无法看到句子中所有的 context。流式模型为了看到更多的上下文,以达到更好的识别性能,会倾向于增强时延较高的路径,如图1中蓝色的路径。如图2蓝色线所示,随着训练进行,没有时延正则的 RNN-T 流式模型的时延逐渐上升。
Delay-penalized RNN-T
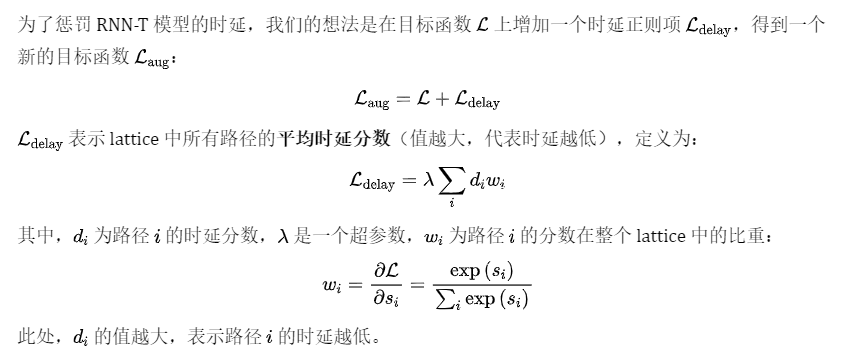
下文会具体讲解时延分数
的定义。
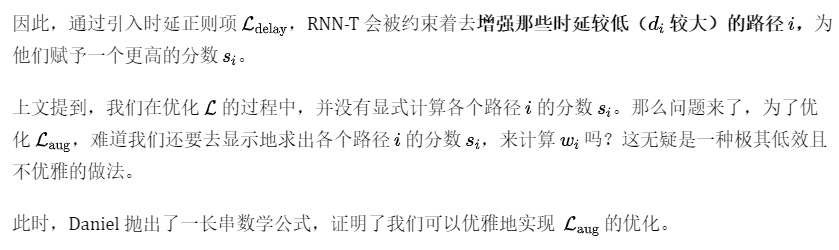
由于篇幅限制,我们不在此列出具体的证明过程。感兴趣的同学可以阅读论文 https://arxiv.org/pdf/2211.00490.pdf,保证学过高中数学的同学都能看懂。
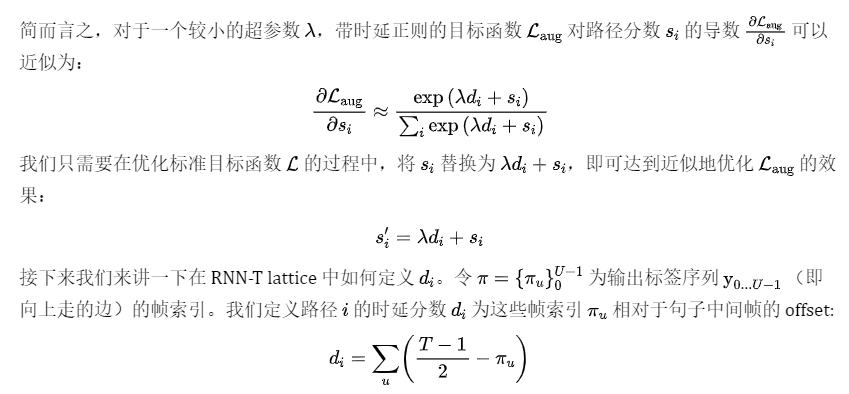
此处,之所以要加上它们相对于中间帧的 offset,是为了使得引入时延正则后,loss 函数的数值不会和原来相差太大。
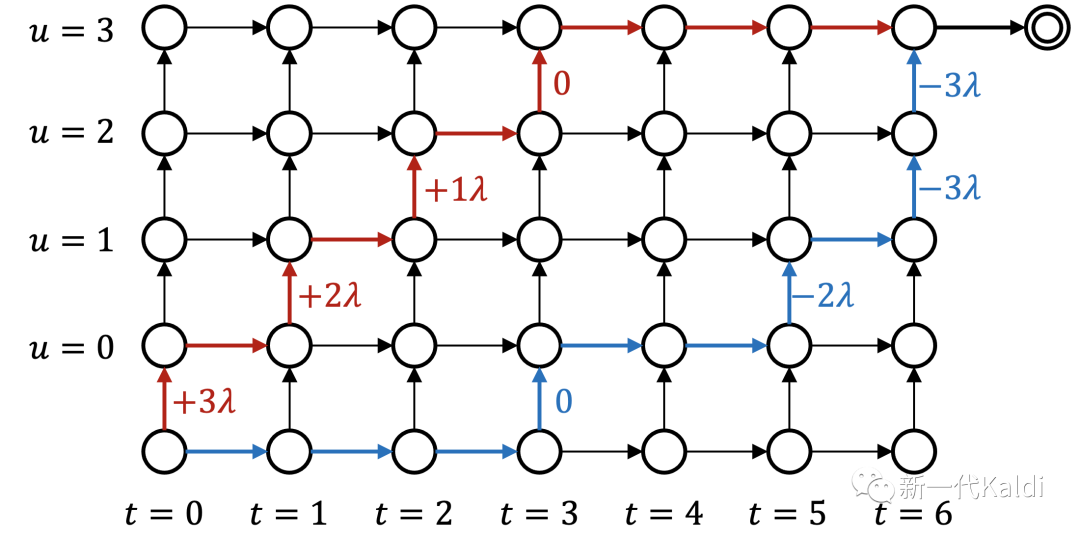
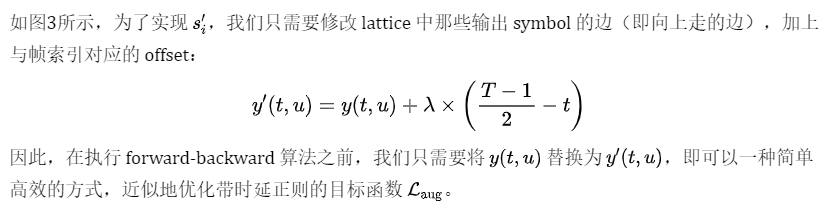
如图2中红色的线所示,通过在 RNN-T 目标函数上添加时延正则项,随着训练的进行,我们可以逐步降低流式模型的时延。
代码可以参考 k2 的 PR https://github.com/k2-fsa/k2/pull/976 和 icefall 的 PR https://github.com/k2-fsa/icefall/pull/654。
3. Delay penalty for CTC
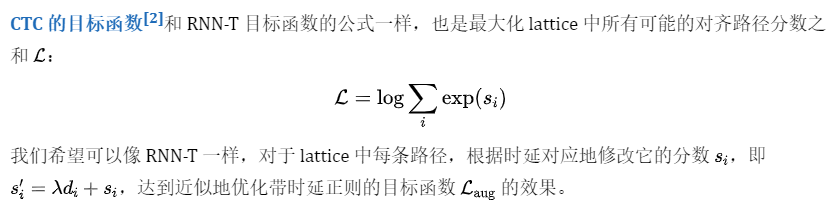
下面将介绍如何使用 k2 fsa 巧妙地实现这个功能。
大家可以下载文件 https://github.com/k2-fsa/next-gen-kaldi-wechat/blob/master/pdf/LF-MMI-training-and-decoding-in-k2-Part-I.pdf,了解如何用 k2 fsa 实现计算 CTC 目标函数。
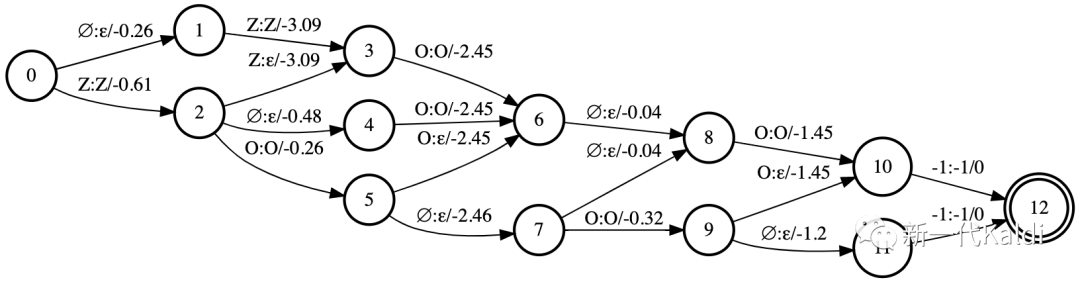
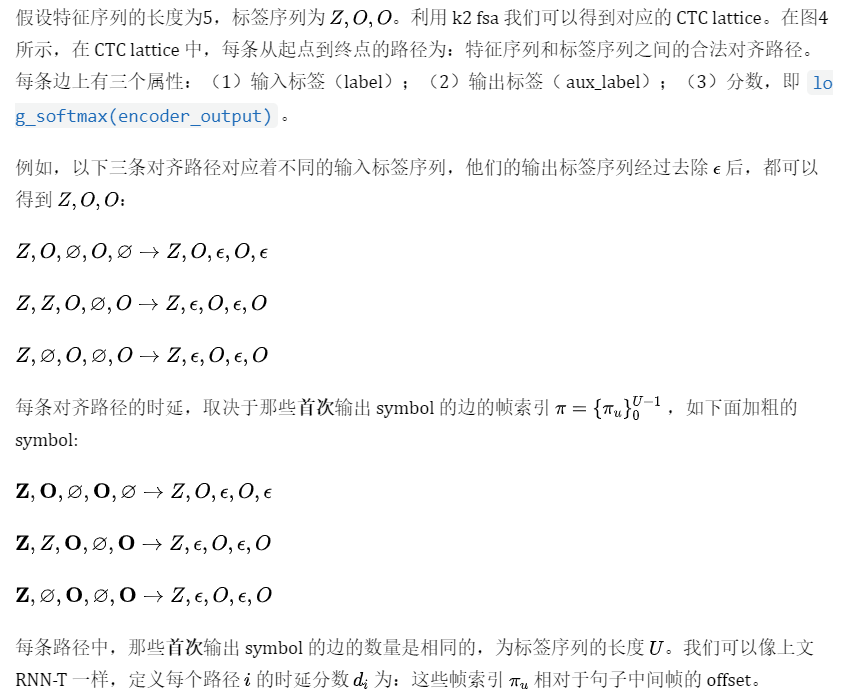
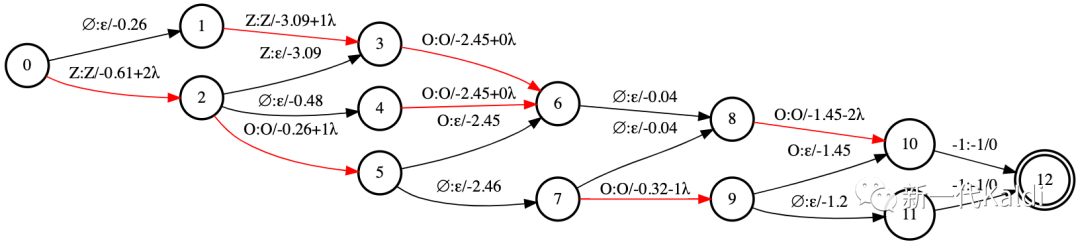
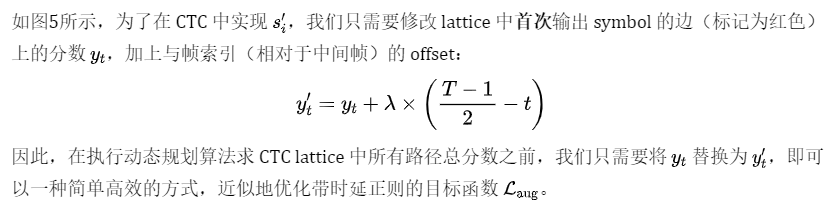
在 k2-fsa CTC 实现过程中,利用
k2.Fsa.get_total_scores()求得 lattice 所有路径总分数。
具体地,如何修改 lattice 上那些首次输出 symbol 的边的分数,可以参考 k2 的 PR https://github.com/k2-fsa/k2/pull/1086,和 icefall 的 PR https://github.com/k2-fsa/icefall/pull/669,里面有详细的注释。
4. 实验结果
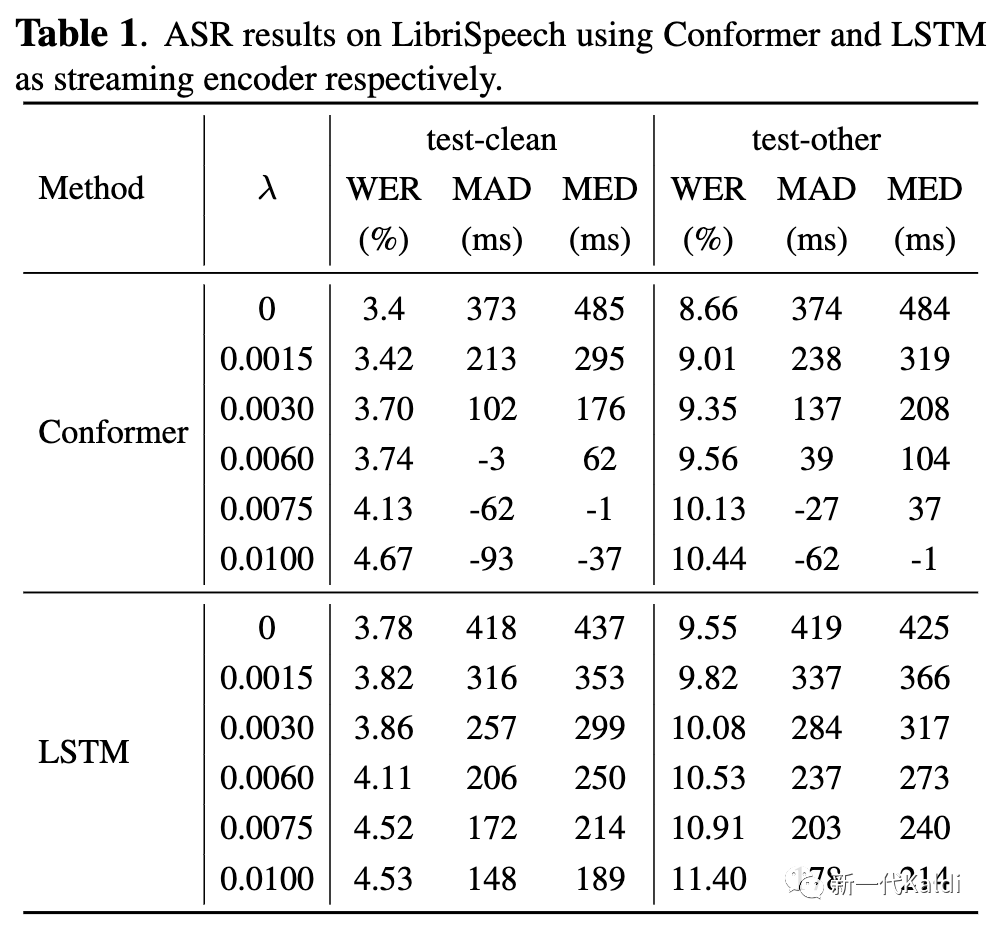
RNN-T
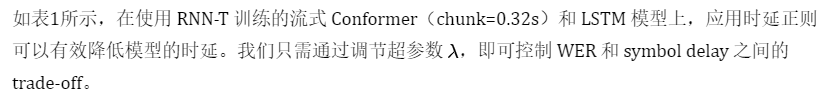
关于 RNN-T 时延正则,大家可以阅读论文 https://arxiv.org/pdf/2211.00490.pdf 了解更详细的实验结果。
CTC
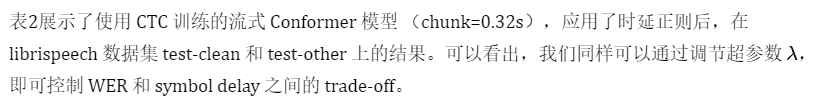
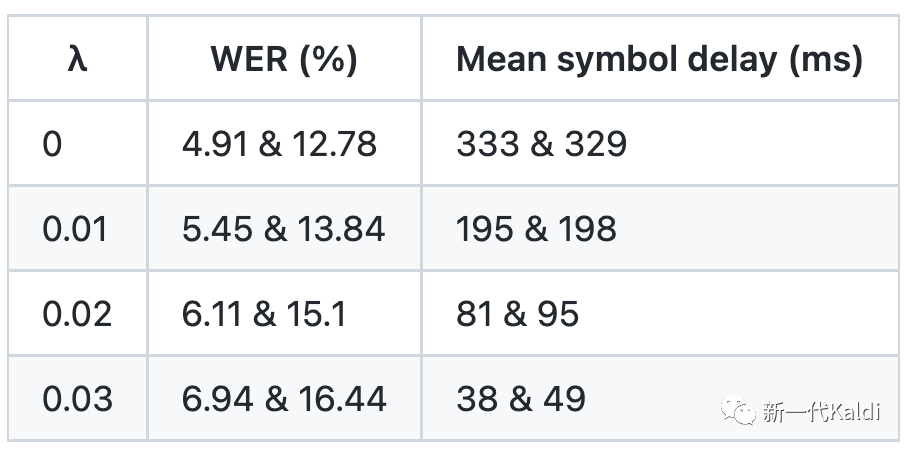
由于模型只使用了 CTC 损失函数训练了 25 个 epoch,WER 较差,大家可忽略其绝对数值。
5. 总结
最后,再附上论文地址 https://arxiv.org/pdf/2211.00490.pdf,感兴趣的同学可以阅读 Daniel 的详细证明过程。有疑问的同学欢迎通过 github issue 或者微信群的方式和我们讨论。
参考资料
1、forward-backward: https://arxiv.org/pdf/1211.3711.pdf
2、CTC 的目标函数: https://www.cs.toronto.edu/~graves/icml_2006.pdf
