
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
语音合成技术作为人机交互领域的核心支撑,旨在将文本信息转化为自然、流畅的语音信号,其性能直接影响智能助手、有声阅读、辅助沟通等场景的用户体验。如何在合成中,让合成的音频更符合人类的偏好,是目前语音合成中研究的一个重要问题。
一、为什么合成语音需要强化学习
传统方法多依赖监督学习框架,通过最大化合成语音与真实语音的相似度(如基于梅尔频谱的损失函数)进行模型训练,虽在清晰度和基本韵律上取得显著进展,但在自然度优化(如情感适配、语气连贯)、长文本建模(如上下文语义一致性)以及个性化定制(如特定说话人风格迁移)等复杂任务中,常因监督信号与实际用户感知目标的错位而难以突破瓶颈。强化学习(Reinforcement Learning, RL)通过智能体与环境的动态交互学习最优策略,能够直接以用户主观评价(如自然度评分、情感匹配度)或长期累积奖励为优化目标,为解决语音合成中 “感知与生成错位” 问题提供了全新思路。近年来,随着深度强化学习技术的成熟,其在语音合成任务中的应用逐渐受到关注,不仅推动了合成语音自然度的跃升,更拓展了个性化、场景化语音生成的可能性,成为连接技术性能与用户真实需求的关键桥梁。
二、强化学习简介
强化学习(Reinforcement Learning, RL)是机器学习的一个重要分支,其核心思想源于对生物在环境中通过试错学习、追求长期奖励的行为模拟。与监督学习依赖标注数据、无监督学习聚焦数据内在结构不同,强化学习的核心在于智能体(Agent)如何在与环境(Environment)的交互中,通过探索与利用的平衡,学习到最大化累积奖励(Reward)的行为策略。
强化学习系统通常包含以下关键组件:智能体(Agent),环境(Environment),动作(Action),状态(State),奖励(Reward),策略(Policy)。强化学习的核心目标不是简单地最大化单步奖励,而是通过学习长期累积奖励的最优策略,使智能体在复杂、动态的环境中持续做出最优决策。
强化学习在大模型(尤其是大语言模型,LLM)中的核心作用是优化模型输出与人类偏好、任务目标的对齐(如安全性、有用性、事实准确性等)。由于大模型参数规模庞大(数十亿至万亿级)、输出空间离散且复杂(token 序列),传统强化学习算法需适配其特性。以下是在大模型中应用最广泛的经典算法及方法:
PPO(近端策略优化)是一种广泛应用于强化学习的策略梯度算法,核心特点是通过限制新策略与旧策略的更新差异(“近端约束”),避免训练中策略突变导致的不稳定问题。它凭借稳定性强、样本效率高、实现简单的优势,成为大模型优化(如 RLHF 流程)中的主流算法,尤其适合处理大模型的高维度参数和离散输出(如 token 序列)场景,能在保证训练稳定的同时高效提升策略性能。
DPO(直接偏好优化)是一种简化的大模型对齐方法,核心是跳过传统 RLHF 中训练奖励模型的步骤,直接利用人类偏好数据(如 “A 输出比 B 输出好”)优化策略模型。它通过最大化偏好输出与非偏好输出的概率差异,在保证对齐效果的同时简化了训练流程,降低了计算成本和奖励模型可能带来的偏差问题,尤其适合对效率要求较高的场景,是 RLHF 的重要替代方案。
- GRPO(群体相对策略优化)是DeepSeek 提出的强化学习算法。其核心是通过组内相对奖励优化策略模型,无需依赖传统的价值网络来估计动作价值。它先对每个输入状态采样一组动作,再依据奖励函数评估动作,通过归一化奖励计算相对优势,进而调整策略模型参数。该算法可减少计算负担,提升训练稳定性,还通过 KL 散度约束让策略更新更可控。
三、从模型“看哪里”来解释:可视归因
在当前语音合成的技术路线中,主要分为非自回归和自回归两类,因其不同的建模方式,强化学习在其中的应用也有些许差异。接下来,我们将分别介绍强化学习算法在自回归及非自回归音频合成技术中的一些应用:
3.1 非自回归语音合成中的强化学习
(1)F5R-TTS: Improving Flow Matching based Text-to-Speech with Group Relative Policy Optimization[1]
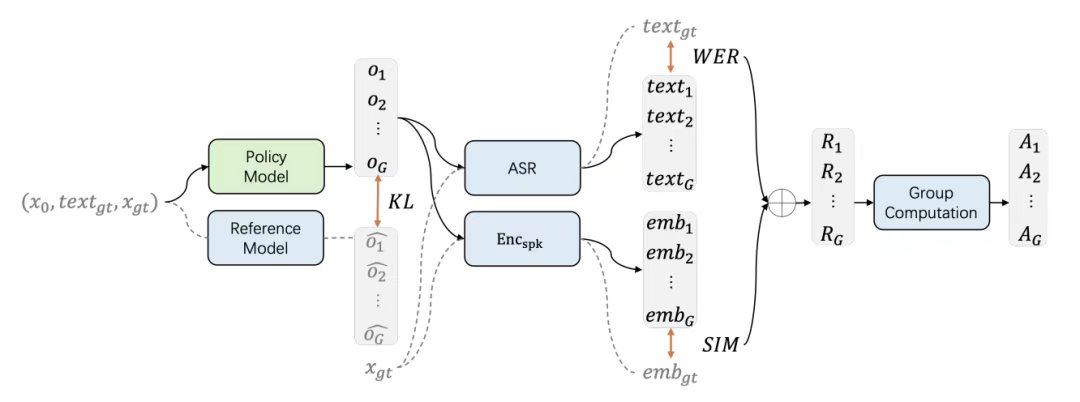
图 1:F5R-TTS 强化学习训练总览
在非自回归语音合成系统中,流匹配算法(Flow-Matching)是非常常用的一个强大的生成模型。但其核心是通过确定性的常微分方程(ODE)将简单分布(如高斯噪声)转换为复杂数据分布。例如,模型通过学习一个向量场,引导粒子从初始噪声沿 ODE 轨迹流动到目标数据分布。这种完全确定性的生成过程缺乏随机性,而强化学习需要通过随机策略探索环境(例如,在文本生成中尝试不同的 token 组合)以优化奖励信号。
因此,该论文提出将流匹配模型的输出重新表述为概率分布。具体来说,模型被修改为预测高斯分布的均值和方差,而不是直接预测确定性的输出值。这样,模型的输出可以表示为一个概率分布,从而为强化学习算法的应用提供了基础。
其次,在非自回归TTS系统中,如何有效地利用强化学习来优化模型性能,特别是在语义准确性和说话者相似度这两个关键指标上。如图 1,该论文设计了一个基GRPO的增强阶段。在这个阶段,模型被进一步训练为一个策略模型,同时初始化一个参考模型以提供约束。GRPO利用两个主要的奖励指标来优化模型:(1)词错误率(Word Error Rate, WER):通过自动语音识别(ASR)模型计算合成语音的转录文本与目标文本之间的词错误率,以此来衡量语义准确性。(2)说话者相似度(Speaker Similarity, SIM):通过说话者验证模型计算合成语音和目标语音之间的相似度,以此来衡量说话者的一致性。通过这两个创新,论文成功地将强化学习整合到基于流匹配的非自回归TTS系统中,并在零样本语音克隆任务中验证了其有效性,实现了显著的性能提升。
(2)DMOSpeech 2: Reinforcement Learning for Duration Prediction in Metric-Optimized Speech Synthesis[2]
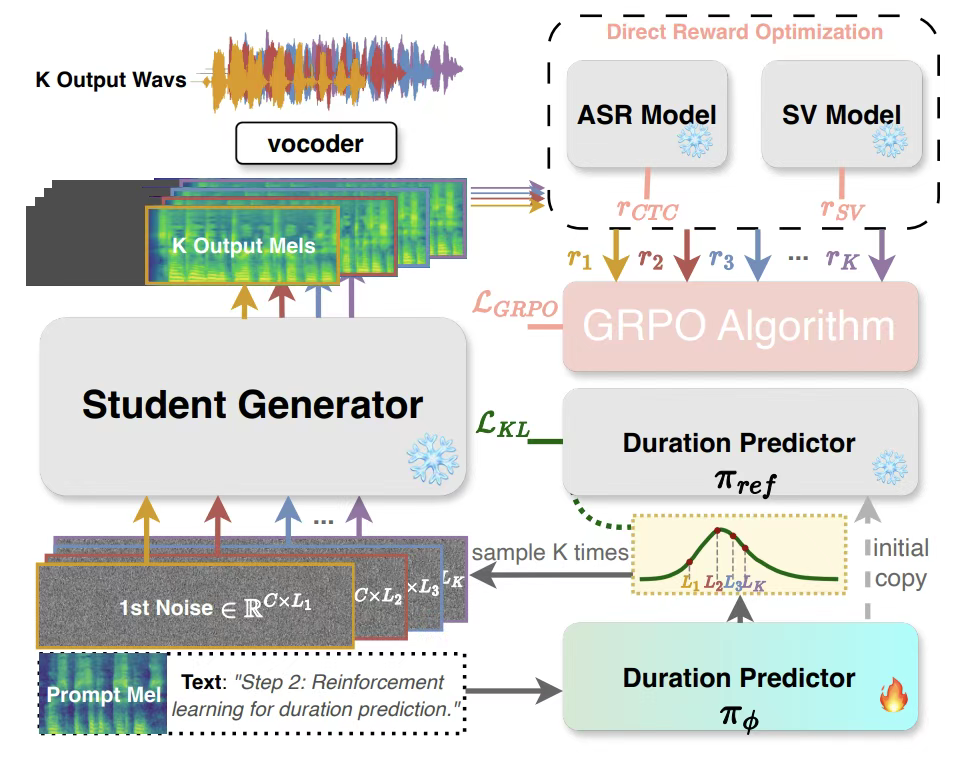
图 2:DMOSpeech2 的框架总览
在非自回归语音合成框架中,时长一般是基于规则直接确定的数值,而不是自回归中通过自回归迭代预测出来的结果,因此时长的正确预测对词错误率和相似度都有比较大的影响。因此,不同于上篇文章去使用强化学习在词错误率和相似度等两个指标上对模型进行直接优化,DMOSpeech2提出通过强化学习方法对持续时间预测器进行优化,使其能够直接针对感知质量指标进行学习,而无需依赖于生成器和持续时间预测器之间的可微分路径。同样取得了不错的效果。
3.2 自回归语音合成中的强化学习
(1)Emo-dpo: Controllable emotional speech synthesis through direct preference optimization
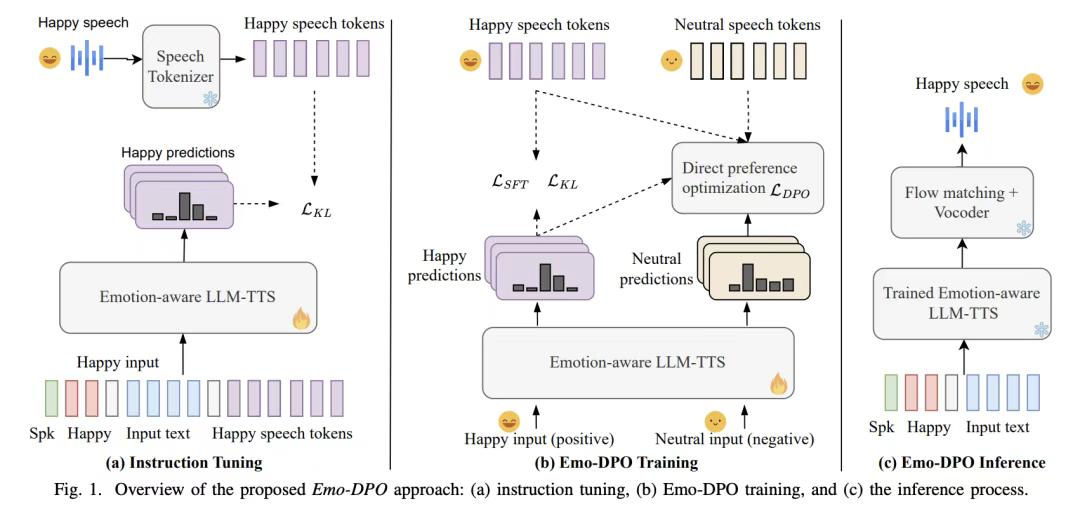
图 3:Emo-DPO 整体框架
该论文通过提出一个名为Emo-DPO的新方法来解决现有情感文本到语音(TTS)模型的局限性。Emo-DPO方法的核心思想是利用直接偏好优化(DPO)技术来区分和优化模型生成的语音中的情感细微差别。详细来讲,即通过构建成对的偏好数据来进一步微调模型,使得模型能够区分并优先生成更受偏好的情感语音。这一步骤通过最大化生成期望情感语音序列的可能性,同时最小化生成不期望情感语音序列的可能性来实现。最终,该情感 TTS 模型能更准确地生成所需情感的音频。
(2)CosyVoice 3: Towards In-the-wild Speech Generation via Scaling-up and Post-training
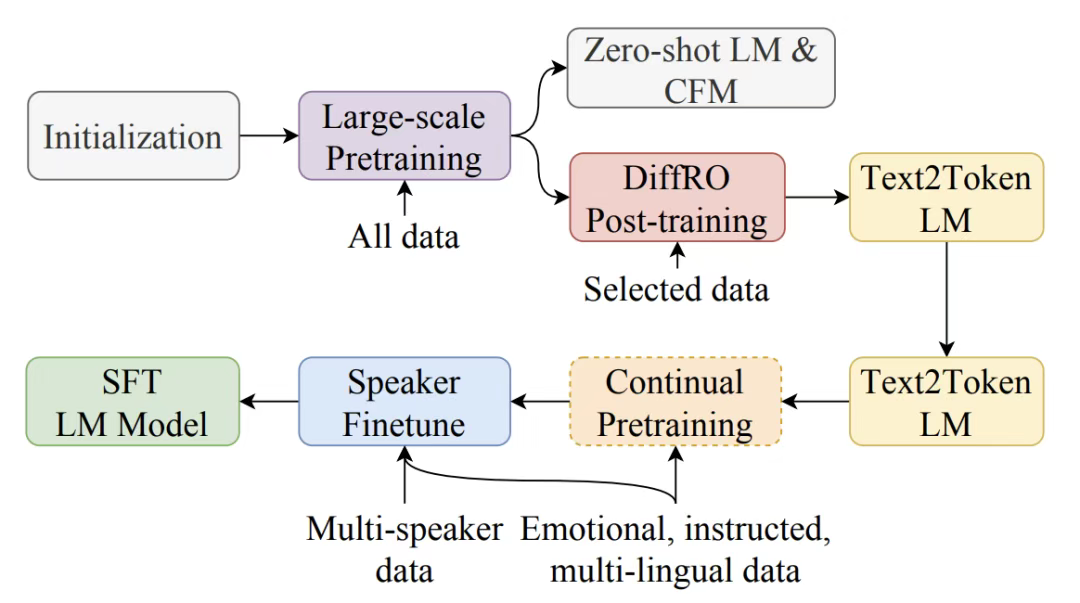
图 4:Cosyvoice3 训练流程
现有的强化学习方法在 TTS 系统中应用有限,且缺乏适用于语音生成模型的通用强化学习方法。于是CosyVoice 3 提出了一种新的可微分奖励优化方法,通过直接优化语音标记而非合成音频,提高了生成语音的质量。具体来说:首先训练一个类似 ASR 的 Token2Text 模型,使用其后验概率作为奖励。然后使用 Gumbel-Softmax 操作对 LLM 预测的标记进行采样,并通过反向传播直接优化语音标记以最大化奖励分数。同时通过 Kullback-Leibler (KL) 散度约束策略更新,防止模型偏离参考模型。
四、总结
尽管强化学习在语音合成中已取得一定进展,但仍面临诸多挑战。例如,语音合成系统的决策空间极为庞大,致使强化学习算法的训练难度大增。并且,在实际应用场景中,还需兼顾实时性和计算效率等问题。同时,语音合成的奖励函数较难定义,如果需要人工标签,则需要大量的人力成本。
展望未来,研究方向主要聚焦在以下几个方面:一方面,探索将更多强化学习算法,如 PPO、DDPO 等,整合到语音合成系统中,以寻求更高效的优化路径;另一方面,设计更为精细、多层次的奖励函数,进一步提升模型在自然度、个性化和表现力等方面的性能;同时,在更大规模、更多样化的训练数据上验证方法的扩展性,深入探究数据规模与模型性能的量化关系。
