
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
在本期文章中,我们将带您了解一个新兴而富有挑战性的跨模态研究方向:视觉生成音乐(Vision-to-Music Generation, V2M)。该任务旨在从图像、视频或人体动作等视觉信号中自动生成语义契合、节奏同步且结构合理的音乐作品,具有广泛的应用前景,如影视配乐、舞蹈伴奏、短视频创作等。
我们将参考由上海交通大学、香港中文大学、北京电影学院等单位学者合作完成的综述报告,系统梳理该领域的方法演进、数据集资源、评价机制与技术挑战,帮助读者快速掌握视觉生成音乐的研究现状。
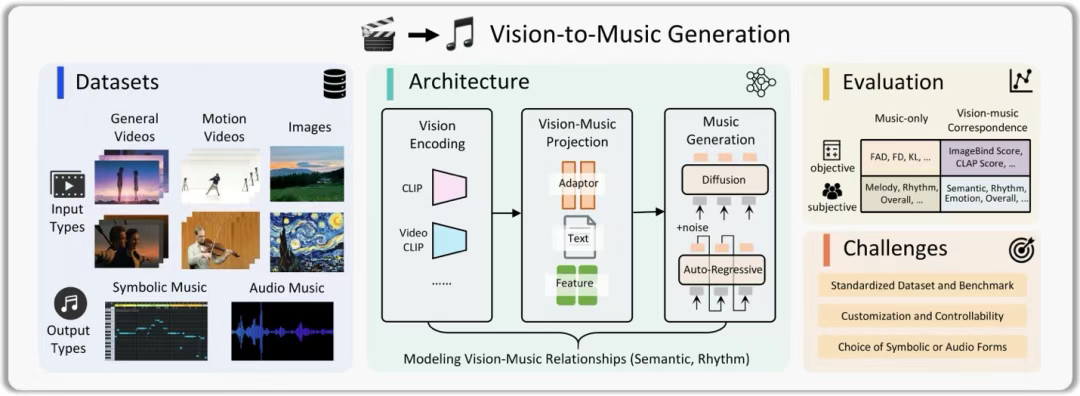
V2M任务
一、任务定义与研究动因
视觉生成音乐的核心目标,是根据输入的视觉内容(如图像、视频、人类动作姿态等),生成在节奏、情感和语义层面与之对齐的音乐输出。输出形式可为符号音乐(如MIDI)或音频信号(如WAV)。
该任务的挑战主要包括:
• 语义对齐:匹配视觉情绪与音乐风格;
• 节奏对齐:同步视觉节奏(如动作幅度、场景切换)与音乐节拍;
• 结构完整性:确保生成音乐具有合理起承转合的结构。
二、数据集现状与分类
当前研究中使用的数据集可根据视觉输入类型与音乐模态进行分类如下:
数据集类型 | 代表数据集 | 输入类型 | 音乐类型 | 特点与限制 |
符号音乐数据集 | SymMV, Video2Music, BGM909 | 视频 | MIDI | 控制性强,易评估;但数量少,注释有限 |
音频音乐数据集 | MV100k, Disco-MV, FilmScoreDB, MusicPro7k | 视频、图像 | 音频 | 多样性强,来源广;但配对质量差 |
人类动作数据集 | AIST++, URMP, LORIS, TikTok Dance | 人体关键点、视频 | 音频 | 关注节奏同步;但数据规模小 |
图像-音乐数据集 | MUImage, EIMG, Shuttersong | 静态图像 | 音频 | 语义关联明确;但缺乏节奏与时间维度 |
音频音乐数据集
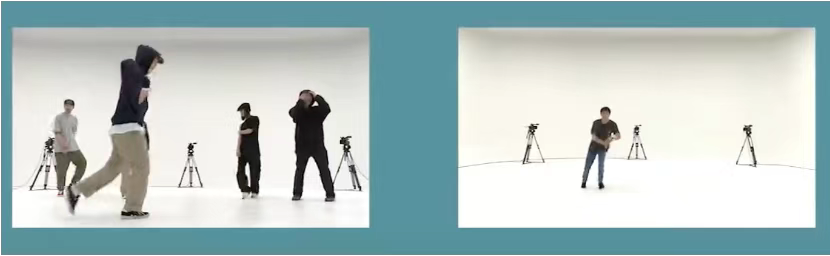
人类动作数据集
三、方法演进与代表模型
视觉生成音乐的研究方法大致可以划分为三个阶段:早期的规则驱动模型、自回归生成方法,以及近年来广泛应用的扩散模型。各阶段方法在节奏控制、语义对齐、数据泛化能力等方面逐步演进。
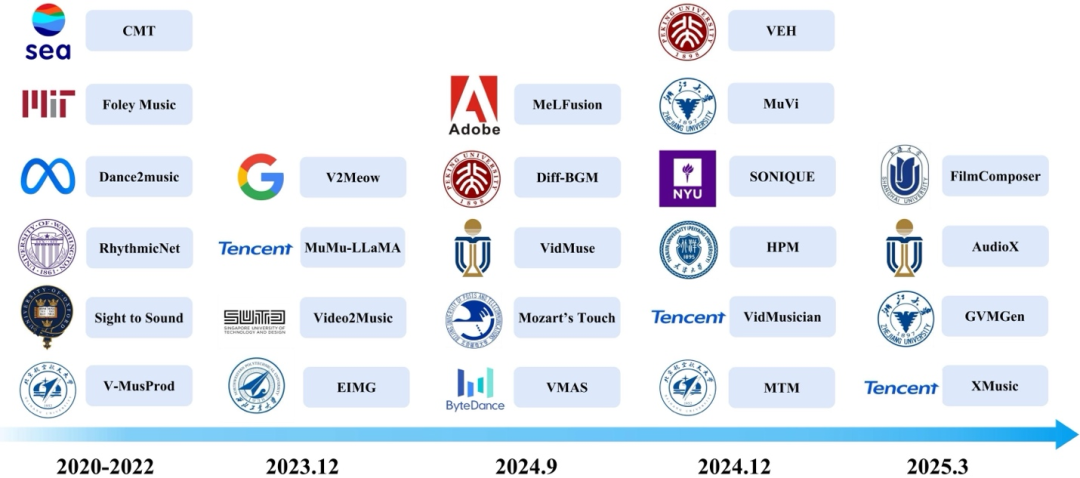
V2M时间线
1. 规则驱动模型
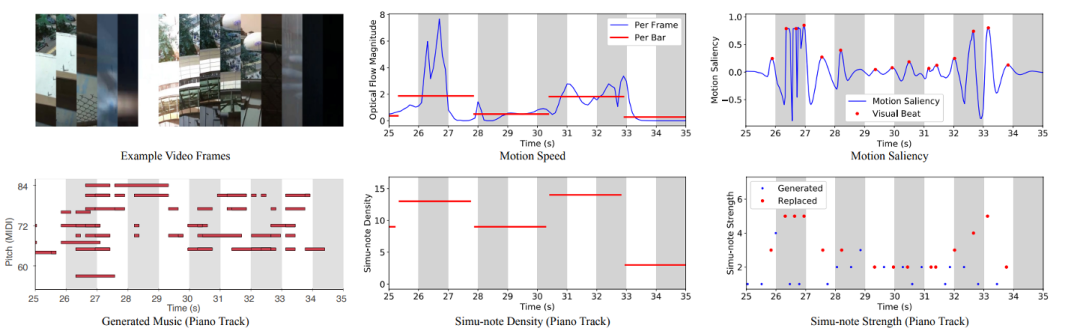
CMT(ACM MM 2021 最佳论文) 是该领域早期的代表工作。该方法提出了一种符号音乐生成框架,基于视觉中提取的运动速度、显著性等特征,通过预设规则映射到节奏密度、音符强度等音乐属性。例如:动作速度越快,生成的音符密度越高;画面变化越显著,音乐的动态越强。最后使用 Transformer 模型实现具体的音乐生成。CMT 最大的贡献是建立了视觉节奏与音乐节奏的可解释联系,但其表达能力较弱,难以适应多样的情绪和风格需求。
CMT
2. 自回归生成方法
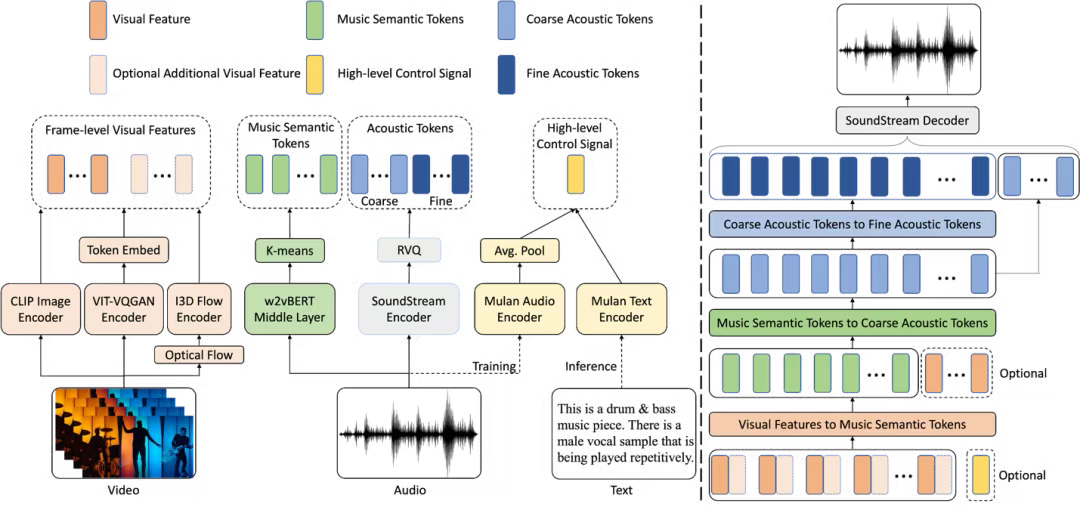
V2Meow(AAAI 2024)是目前主流方法之一,借鉴了 MusicLM 的三级结构:第一阶段提取音频语义表示,第二阶段实现视觉与音频的模态对齐,第三阶段通过自回归生成器输出音频片段。其训练数据规模达10万对视频-音乐配对,具备较强的泛化能力,适用于短视频场景。但由于缺乏显式的节奏控制机制,其生成结果更注重情绪连贯性,节拍同步性不足。
V2Meow
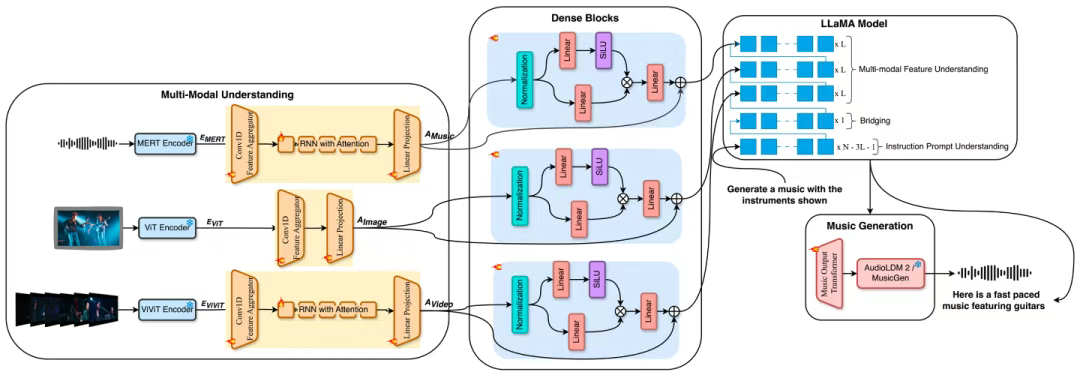
MuMu-LLaMA(2024)进一步引入大语言模型范式,构建了具备音乐理解、视觉感知、音乐生成和编辑能力的统一架构。该方法将 V2M 任务分解为多步操作,每一步通过 LLaMA 微调模块独立完成。尽管具备灵活性和多功能性,但其目前缺乏节奏控制模块,尚难以满足舞蹈等场景的实时节奏对齐需求。
MuMu-LLaMA
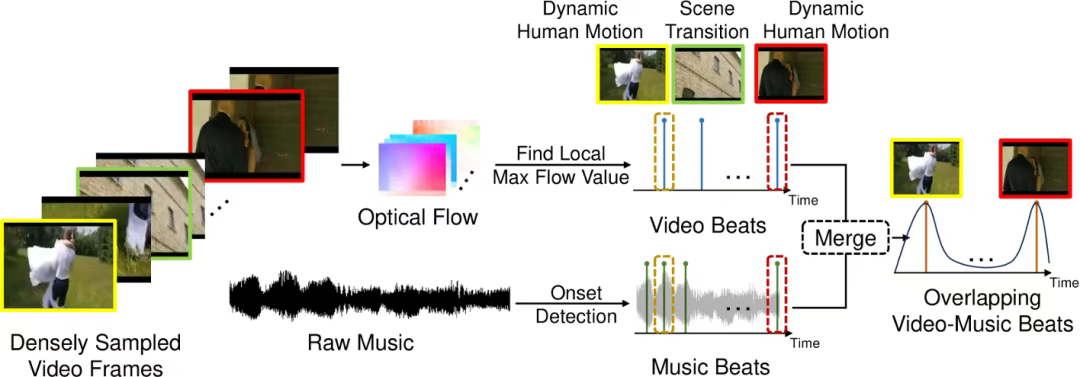
VMAS(WACV 2025 Oral)强化了节奏对齐能力。该方法采用编码器-解码器结构,结合视觉-音频对比损失进行训练,同时引入 Beat-aware 监督信号,确保视频中的节拍变化可在音乐生成中同步体现。其训练数据量达14k小时,且在多个节奏同步任务上表现优异,是当前节奏对齐最为精准的方法之一。
VMAS
3. 扩散模型方法
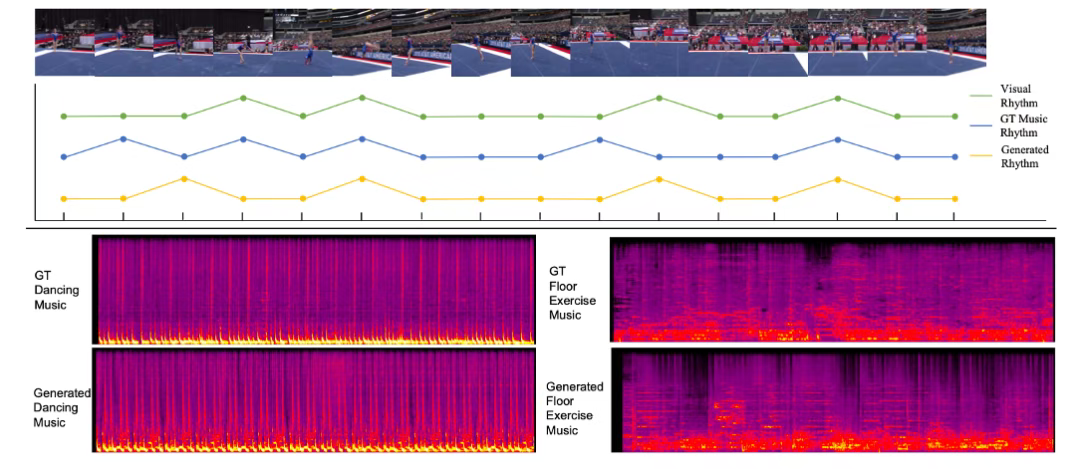
LORIS(ICML 2023)是首批将扩散模型用于动作驱动音乐生成的工作。该方法以人体动作的关键点轨迹为输入条件,通过扩散建模学习节奏生成空间,同时增加了体操和花样滑冰的数据,最终生成结果在运动与音乐节奏匹配度方面显著更优,特别适合舞蹈等任务场景。
LORIS
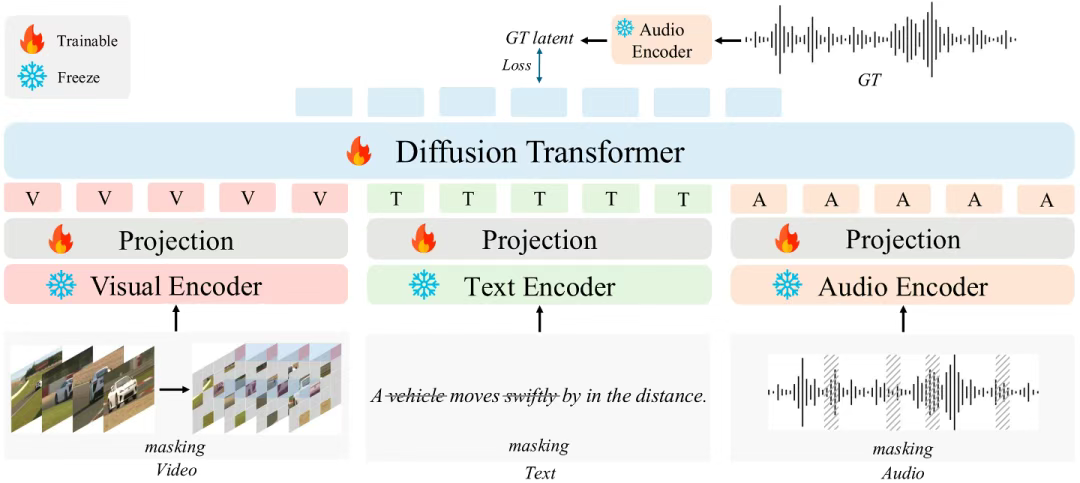
AudioX(2025)则提出了更通用的视觉-音乐映射方式,采用 DiT(Diffusion Transformer)框架,在条件生成中引入掩码机制(Mask Completion)。作者在对比实验中发现,直接在输入信号层面进行掩码建模比在特征空间中操作更有效。在 1.1B 模型规模下,AudioX 在多个 benchmarks 上取得领先性能。
AudioX
四、评价机制与挑战
视觉生成音乐的评价可分为“音乐质量”与“视觉-音乐一致性”两类:
评价维度 | 具体指标或方法 |
音乐本身质量 | Pitch Entropy、结构指标、Grooving Pattern Similarity |
音频客观评估 | FAD、KL散度、IS分数 |
跨模态语义对齐 | ImageBind 表示提取,基于检索精度评估 |
节奏同步性 | CLAP、ImageBind 表示提取,基于检索精度评估 |
主观评价 | MOS、偏好测试:质量、节奏匹配、语义/情绪一致性 |
当前面临的主要挑战包括:
1. 缺乏统一的 benchmark 数据集与标准化评价流程;
2. 情绪与节奏对齐间存在内在张力,需在结构完整性与瞬时对齐间权衡;
3. 多数模型仅支持视频或动作等单一模态输入,尚未实现全面整合;
真实应用场景(如影视、AR、广告)中存在跨领域迁移困难,泛化能力不足。
五、总结与未来展望
视觉生成音乐作为跨模态生成领域的重要方向,已初步形成以自回归与扩散模型为主的技术体系,并开始探索 LLM 融合与指令生成等前沿范式。
研究趋势正在从“节奏驱动”向“情感表达”演进,未来有望结合音乐理论知识、强化语义-节奏的双重控制机制,实现个性化、情感化的音乐生成能力。
值得关注的未来方向包括:
• 构建统一的多模态 V2M benchmark
• 实现图像/视频/动作统一处理能力
• 结合自监督学习与边缘部署,推动落地应用
