
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
在我们的日常生活中,语音合成 Text-to-Speech(TTS)技术已广泛应用于语音助手、有声读物、无障碍服务、影视配音等多个场景。然而,这些“人工声音”往往过于干净,远离现实环境,缺乏真实的感官体验。
我们讲话时所处的环境,无论是图书馆的静谧,还是街头的喧闹,都在潜移默化地影响着我们的语音方式,也影响着听者对说话内容的感知。这就是环境感知语音合成(Environment-Aware TTS)技术正在尝试解决的问题。
一、为什么合成语音需要“背景声”
1. 真实语音总伴随环境
人类从不在“真空”中说话。无论是夏日街道的蝉鸣,还是马路上的车流声,这些声音构成了语音的听觉背景,也传递着场景氛围和语境语气信息,使听众更有身临其境的感受。
2. 背景声增强真实感与可信度
听众在听到带有自然环境噪声的语音时,会更容易相信信息来源于真实场景。缺失背景噪声的合成语音听起来脱离情境,削弱了真实性。
3. 促进多模态融合
在游戏、虚拟现实、播客等应用中,环境感知语音能更好地与图像、动画、空间音效融合,使整体体验更具立体感与沉浸感。
二、为什么不能简单地“叠加背景音”
很多人可能会想,在合成干净语音后叠加上一些环境声不就能解决问题了吗。但是真正自然的 TTS 系统必须从生成层面“理解”并“融入”环境,简单“叠加”会出现以下问题:
1. 忽略隆巴德效应
人类在嘈杂环境中会本能地调整自己的发声方式,包括加大声量、放慢语速、提高音高等。若合成语音未能模拟这种现象,听起来就会不真实。
2. 内容与背景脱节
环境声有时需与关键语音内容同步配合,例如演讲结束时的掌声,这类同步关系无法靠简单叠加精准呈现。
三、环境感知语音合成技术进展
接下来,我们将介绍几种近年来环境感知语音合成技术的进展。
1. 基于嵌入提取器的环境建模
来自香港中文大学的 Tan 等人在论文《Environment Aware Text-to-Speech Synthesis》中提出了一种基于嵌入模块的环境感知语音合成方法。研究者设计了两个嵌入模块,分别用于提取说话人特征和环境特征,并将提取到的特征联合输入到TTS模块中进行生成。
为了实现更有效的特征解耦,作者没有采用传统的分类损失,而是引入了一种基于相似度矩阵计算的聚类损失函数。该方法鼓励来自相同说话人(或环境)但不同条件下的嵌入向量彼此接近,同时与其他类别保持区分,从而在特征空间中形成更加清晰的聚类结构。这种设计提升了模型对说话人与环境的区分能力,从而增强模型处理不同说话人和环境组合的泛化能力。
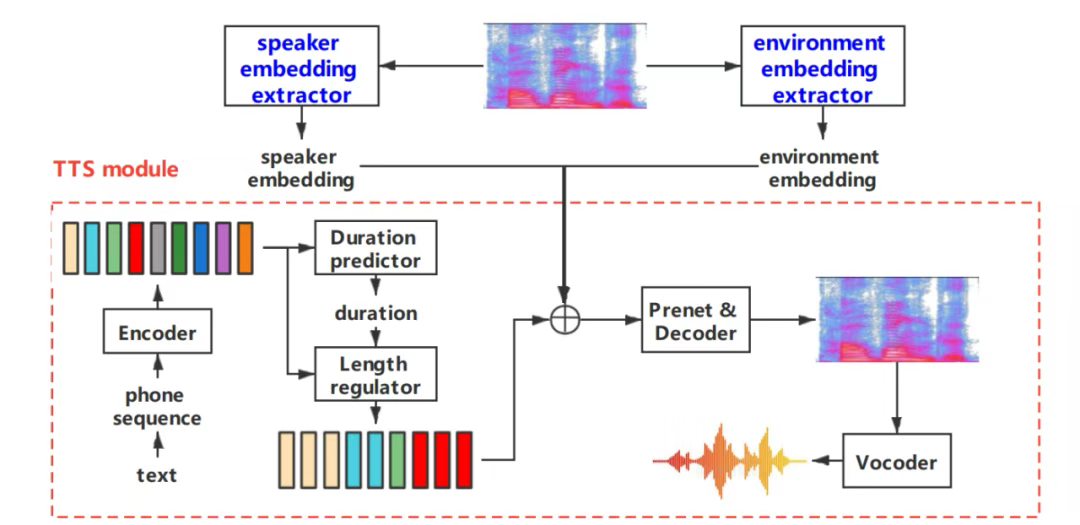
图1 《Environment Aware Text-to-Speech Synthesis》系统概述
2. VoiceLDM:基于扩散模型的语音生成
KAIST的Lee 等人提出了VoiceLDM 方法,以环境描述提示和语言内容提示作为输入,基于 Latent Diffusion Model,实现对语音内容和背景环境的联合生成。
研究者设计了Dual Classifier-Free Guidance,在推理阶段能够对环境描述提示和语言内容提示分别赋权,在模式覆盖和样本保真度之间进行更加灵活的权衡取舍,从而在生成过程中实现更高水平的可控性。
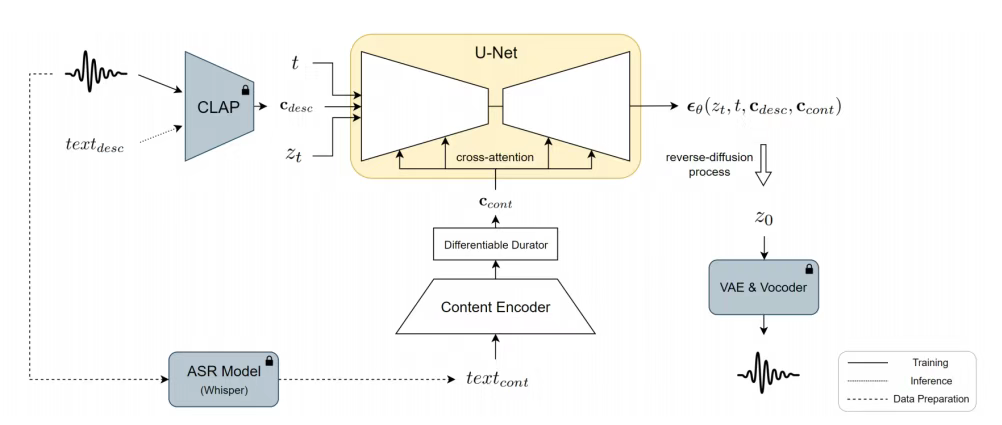
图2 VoiceLDM系统概述
3. VoiceDiT:双条件扩散Transformer
VoiceDiT 是KAIST的Jung和Ahn等人提出的一种面向环境感知语音与音频生成的多模态生成模型。
研究者设计了一种大规模数据构建机制。首先构建了一个庞大的合成语音数据集用于预训练,进一步使用筛选后的真实数据进行微调,缩小模型从“模拟”到“真实”环境的泛化差距。
他们提出了一种双通道的扩散Transformer架构,能有效地保持语音与文本之间的对齐关系,同时准确捕捉环境中的声音特征;通过引入基于扩散模型的跨模态映射器CLIP,模型能根据图像输入生成与场景相匹配的环境声音,从而实现图像与音频之间的融合。
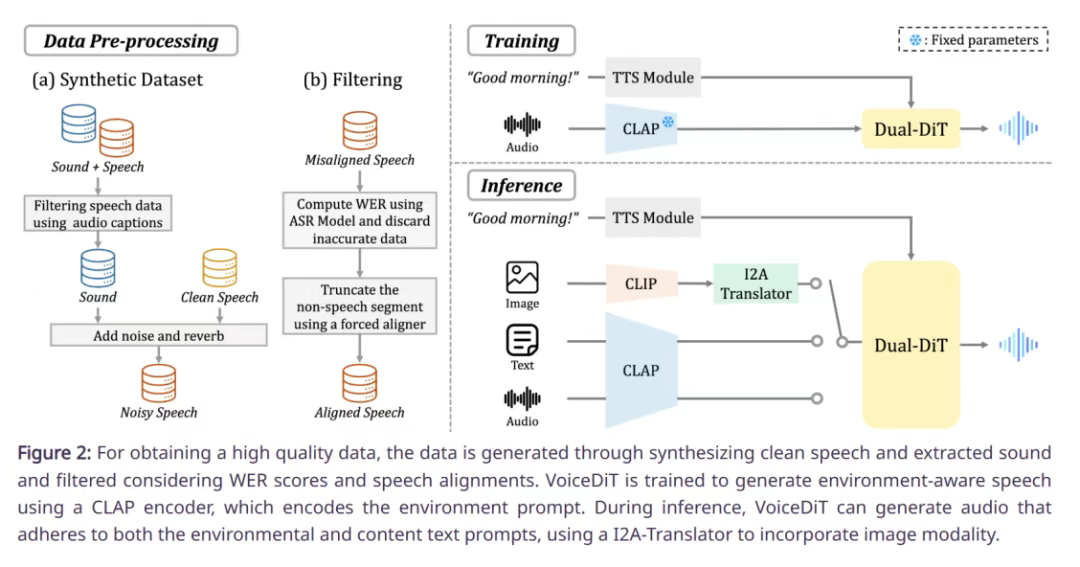
图3 VoiceDiT系统概述
4. UmbraTTS:基于Flow Matching的自监督环境建模
UmbraTTS 是N. Glazer等人提出的一种基于流匹配(Flow Matching)的环境感知语音合成方法。该模型具备对背景音量的精细控制能力,并能够生成具有多样性和上下文一致性的音频输出。
针对现实中缺乏自然语音与环境音对齐数据的问题,研究者设计了一个自监督的数据构建与训练流程,从未标注的原始录音中自动提取语音片段、背景声音以及对应文本,实现对模型的有效训练,摆脱对人工标注数据的依赖。
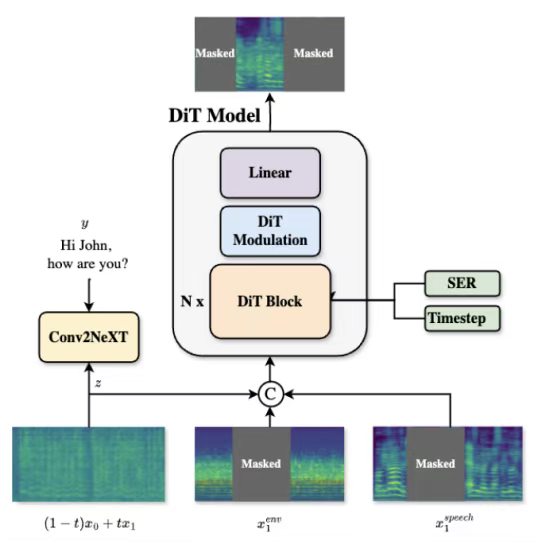
图4 UmbraTTS结构
四、总结
环境感知语音合成让合成语音不仅“发声音”,更“懂环境”,能够根据场景智能调整语音特性和背景氛围,从而实现自然、可信和沉浸的听觉体验。各研究团队的方案侧重不同技术路径:从环境嵌入解耦、扩散式联合生成,到多模态 Transformer 架构,再到自监督流匹配学习,每一种都是迈向更真实环境语音的探索。
