
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
1、任务介绍
声音事件检测(Sound Event Detection,SED)即检测一段音频信号中发生了哪些声音事件,以及这些声音事件在什么时间段发生。该任务通常关注通用声音(universal sound)事件的检测,即除了研究较多的语音和音乐外,还关注日常生活中的各种环境音,例如雨声、汽车引擎声、鸟叫声、键盘敲击声、脚步声等。另外,声音事件检测又分为polyphonic SED和monophonic SED,前者需要检测可能发生重叠的多种声音事件,而后者仅针对无重叠声音事件的检测。Polyphonic SED显然更符合现实需求,现在的研究也基本都属于这类。
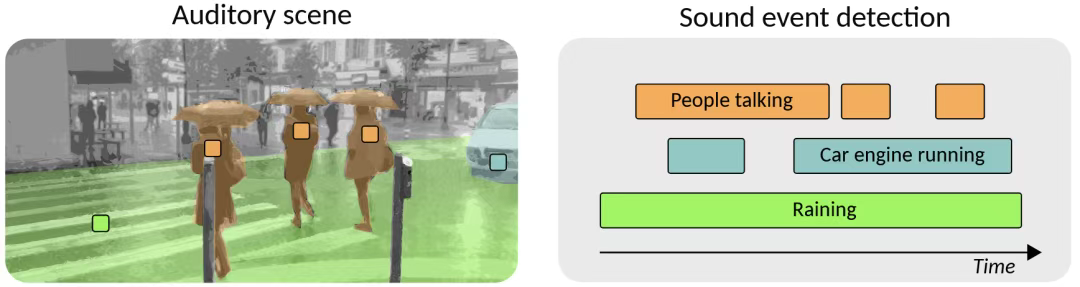
图1:声音事件检测任务示意
声音事件检测任务中的一些挑战:
1. 不同种类的声音,其声学特征可能有较大的差异:有些声音很短、很急促,比如玻璃破碎的声音;有些声音比较长、比较舒缓,比如提琴的声音;有些声音是断断续续的,比如脚步声和鸟叫声。
2. 声音事件之间可能发生重叠,这在真实场景下很常见,且一般没有明显的规律。
3. 对于声音事件的类别缺乏统一的规定,各个任务的声音事件集合及具体划分往往存在较大差异。这给多个数据集的结合使用以及数据标注带来了困难。
4. 因为不同声音事件检测任务通常面向不同的预设环境,而环境本身是多种多样的,因此缺乏比较通用的、普遍用于评估的数据集。
2、任务分析
实际上,声音事件检测任务可以视为在各个小时间段上的多类多标签的分类问题。在每个时间段上,可能有一个或多个声音事件发生,也可能没有声音事件发生(即沉默段,亦或者声音不属于需要检测的目标声音事件中的任何一类)。若系统考虑N个声音事件类,那么在每个时间段上,都有N个二分类的问题。此时系统的输出应为一个0/1矩阵,一边长为N,另一边长为时间段的数量。
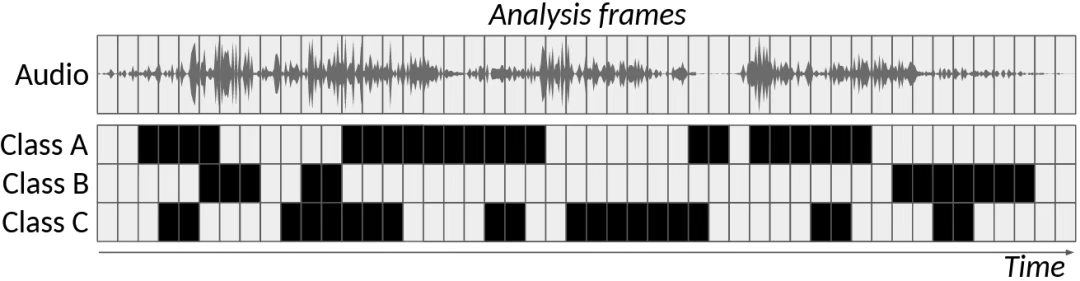
图2:声音事件检测系统的输出
需要注意的是,系统输出在时间上的分辨率跟对音频进行建模分析的分辨率并不一定需要一致,往往会低很多,例如几百毫秒或者一秒为一小段。在极端情况下,将整个音频作为一段,声音事件检测任务就退化为了音频标注(Audio Tagging,AT)任务。
另外,系统的输出通常需要经过一些后处理:
1. 当输出的时间分辨率较高时,对于一些很短的声音事件(比如仅持续一两个小段),若其时长不符合实际(例如本该较长的风声仅持续了200ms),则将其舍弃掉。
2. 检测到的某种声音事件的连续发生之间存在零星的空隙时,可能会填补空隙以构成一整个声音事件。这在断断续续的声音事件上比较常见,例如脚步声和闹铃声等。
3、数据收集
两种标签:
1. 强标签(strong labels),带时间信息的标签,最适合声音事件检测系统的训练,但标注比较困难,且人工标注难以确保准确性,若标注者的专业程度不高,会得到脏标签(noisy labels)。
2. 弱标签(weak labels),整段音频对应一个标签,标注容易,但用于声音事件检测系统的训练时需要额外的处理。
标注数据时,通常需要先规划好声音事件的类别,然后标注者在标注音频时对每一类进行检查。
除了标注之外,还有另一种获得强标签的方法:合成音频,这种方法将不同的声音事件混合起来,可以获得准确的强标签。合成音频的优点在于数据生成非常快,且能够模拟各种声音场景,加入不同的背景噪声,数据多样性较强;而缺点在于生成的音频可能不能很好地模拟真实数据,跟真实录制的音频之间存在或多或少的不匹配,导致训练出来的模型在真实数据上的表现不佳。
一些声音事件检测数据集:
AudioSet,按层次结构组织的527类,共两百多万条音频,每条音频长10秒,共计5000多小时。标签为弱标签,来自于YouTube视频的标签或者元数据,部分经过验证。数据集很大,但总的来说比较脏。
TUT Sound Events 2016,共18类,主要是真实录制的住宅区和家庭的环境声,共2小时,标签为强标签。
Urban Sound,共10类,记录了城市里的环境声,共3小时,为合成音频,标签为强标签。
FSDnoisy18K,共80类,共90小时,弱标签,类别较多,比较脏。
FSD50K,共200类,共100小时,弱标签
ESC-50,共50类,共3小时,弱标签
DCASE challenge提供的数据集,DCASE challenge是聚焦于声音事件检测等任务的比赛,每年都会发布相关的比赛数据集。
4、性能评估
评估声音事件检测系统的输出时,直接将模型的输出跟参考标签比较是不合适的,因为:
1. 声音事件检测系统输出的时间范围跟参考标签的时间范围相差不大时(例如几十毫秒或一两百毫秒),通常将其视为合理的误差,而不判断为错误。输出粒度较细时,这类误差是很常见的,应采取措施来应对。
2. 人工标注的强标签的精准度并不高,很多声音事件在细粒度下很难界定时间范围,因此标签本身并不是那么可靠。
基于上述问题,一般有两种评估方式:基于段的评估和基于事件的评估。
基于段的评估即使用较粗的粒度(例如1秒)进行评估,此时对系统输出的判断将比较宽松,能避免一些小的时间误差错误地影响性能评估。
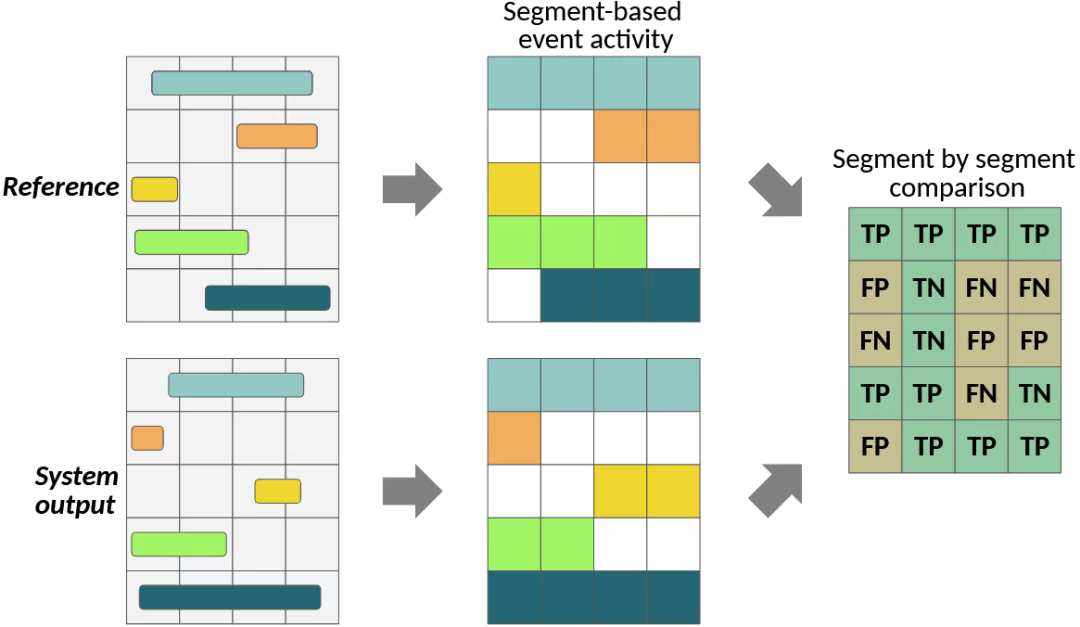
图3:基于段的评估
基于事件的评估即对声音事件一个接一个进行评估,对于每个声音事件,在开始或结束的位置提供某个时间范围的容错机会,同样使评估更加宽松、合理。
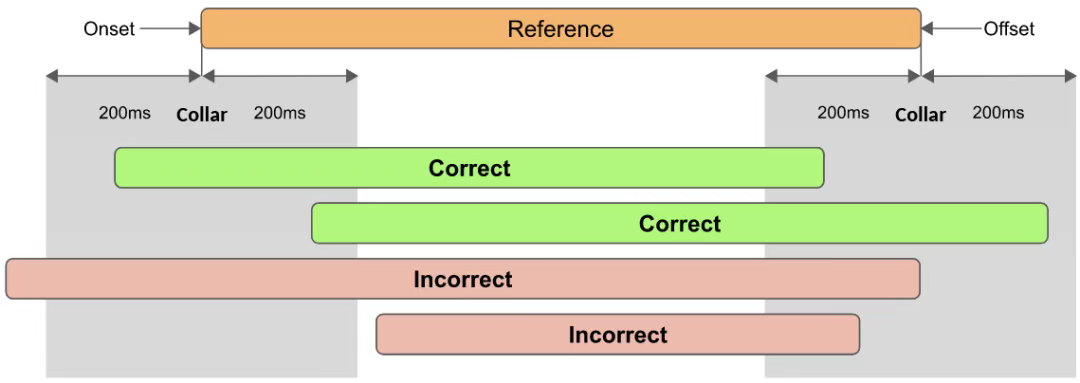
图4:基于事件的评估
具体的评估指标:
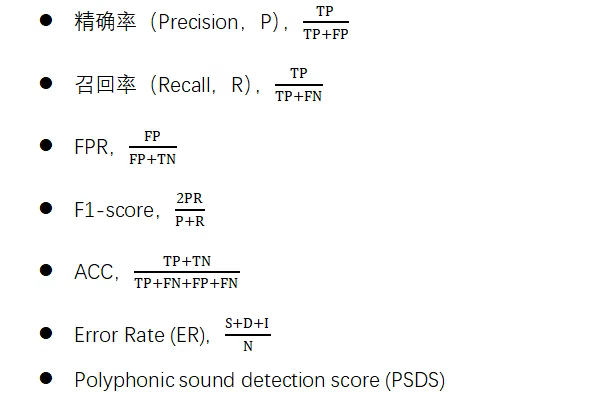
TP、FP、TN、FN中,P表示输出判断声音事件存在,N表示输出判断声音事件不存在,T表示输出的判断跟参考标签相符,F表示输出的判断跟参考标签不符;S、D、I则是参考了编辑距离(edit distance)问题中的替换(substitute)、删除(delete)、插入(insert),N即TP+FN。它们的具体统计方式可参考下两图。
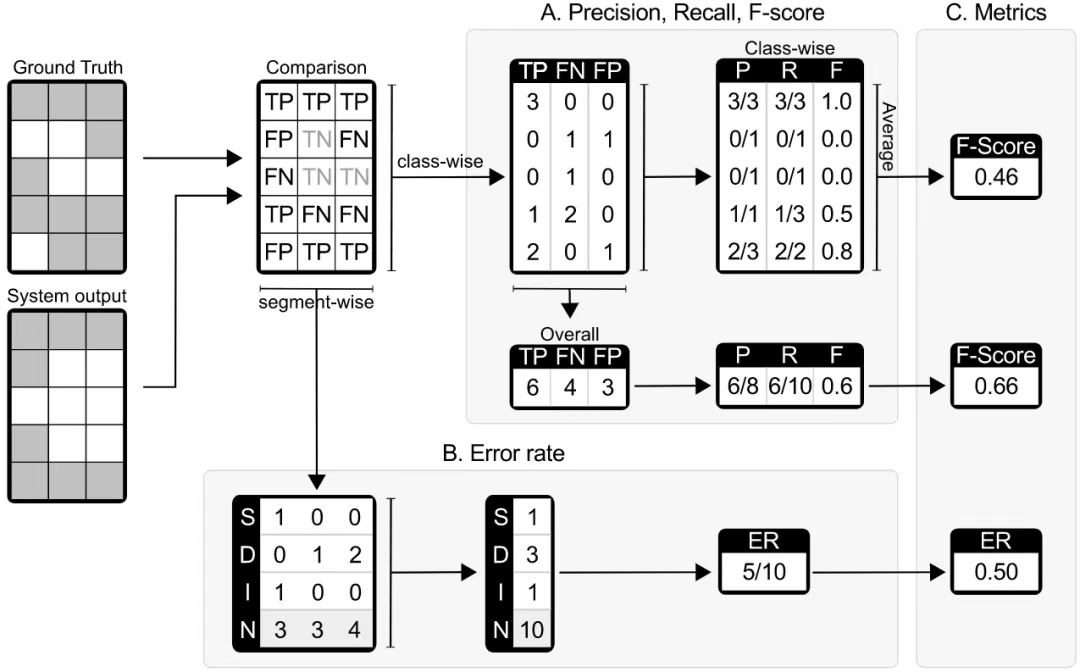
图5:基于段的评估中各项指标的统计
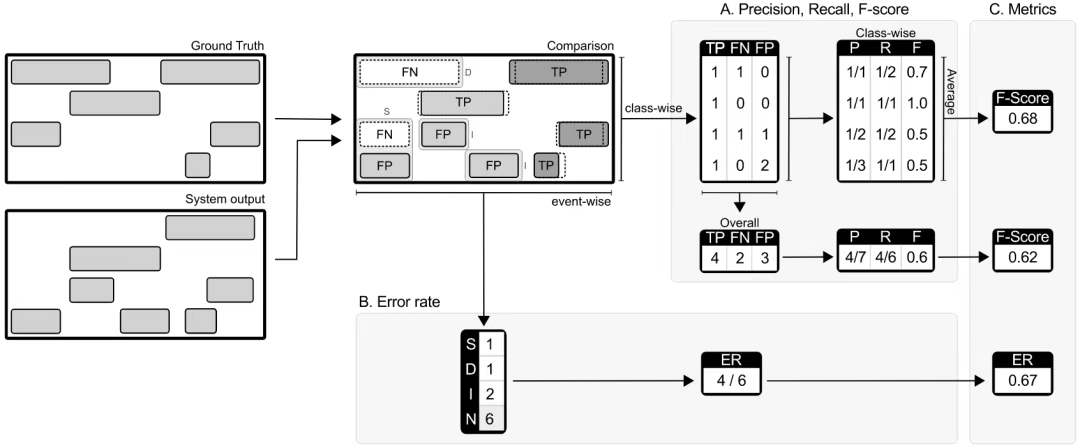
图6:基于事件的评估中各项指标的统计
5、系统方案
主流方案:监督学习
早期包括使用GMM、HMM的方法,现在的方法则是基于深度神经网络(Deep Neural Network,DNN)。基于DNN的方法能够自然地解决多标签分类问题,且具备高性能,能够应对复杂的场景。
最经典的用于声音事件检测任务的DNN结构是CRNN,它是CNN和RNN的结合,既可以利用CNN部分捕获局部的高级特征,又能通过RNN部分建模时序上下文。CRNN使用log mel energies作为输入特征,这也是声音事件检测系统比较常用的一种输入特征。
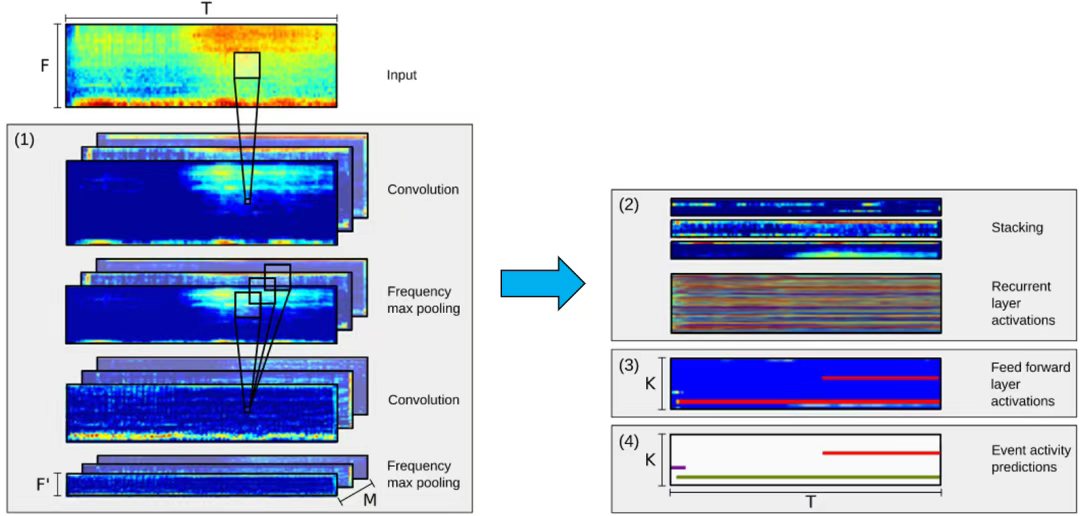
图7:CRNN的模型结构
当然,CRNN已经是2017年的方法了。现在的声音事件检测系统很多都采用了迁移学习的方法:先在大规模数据集(如AudioSet)上预训练基础模型,再附加一个分类头在声音事件检测的目标数据集上进行微调训练。这种情况下,声音事件检测其实是作为一个下游任务,性能很大程度上取决于预训练的基础模型,相对于传统的CRNN等模型会有更优的性能。这类模型的例子有:PANN、BEATs、EAT、M2D、CED、Dasheng等。
另外,如何使用弱标签、脏标签进行训练,也是一个研究方向,这里不作展开。
6、总结
声音事件检测是一种在现实生活中应用场景广泛的技术,对其的研究也已有较长的历史。本文从声音事件检测的任务内容、技术分析、数据收集、性能评估以及常见的系统方案几个方面对该技术做了大致的介绍,希望对声音事件检测感兴趣的读者能带来入门帮助。
