WeNet更新:支持 CTC alignment

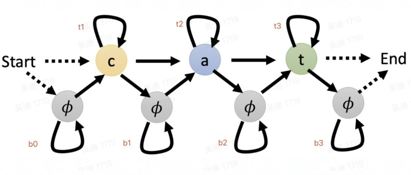
Force alignment(强制对齐)是语音任务中的一个常用模块,在帧级别的语音识别和语音合成任务中应用广泛,同时也是字幕自动打轴、口语评测等任务中的核心算法。强制对齐和识别解码有一定的相似性,识别解码是指给定一个语音识别模型,输入一个…
199 0 0

Force alignment(强制对齐)是语音任务中的一个常用模块,在帧级别的语音识别和语音合成任务中应用广泛,同时也是字幕自动打轴、口语评测等任务中的核心算法。强制对齐和识别解码有一定的相似性,识别解码是指给定一个语音识别模型,输入一个…
WeNet更新支持了时间戳。解码器不仅可以返回 Nbest 解码结果,而且还可以返回其中每个字对应的时间信息。 在语音识别一些任务中,字级别的的时间戳和N-best 扮演着重要的作用。例如在视频应用中,语音识别结合字级别的时间戳可以在精确的…
希尔贝壳和出门问问合作,在 WeNet 中更新了对 AISHELL-2 数据集的支持,开放数据准备、训练和解码测试和部署等流程,并开放基于 AISHELL-2 的预训练模型。其中,AISHELL-2 数据由希尔贝壳提供。希尔贝壳开源数据致力…
WeNet是出门问问联合西北工业大学推出的端到端语音识别工具,并且已经开源在Github上。为了方便大家使用,本文将教大家如何在Android手机中构建一个语音识别系统。 本文示例运行的环境为CPU (Intel x86_64) + Mac…
WeNet自发布以来,日前已经成为最流行、最受欢迎的开源端到端语音识别工具。下图是几个典型端到端识别工具Github的Star History。 目前,WeNet已经支持了AIshell-1, AIshell-2, LibriSpeech三…
出门问问联合西北工业大学音频语音与语言处理研究组推出面向产品和工业界的端到端语音识别开源工具WeNet,WeNet致力于消除从端到端模型研究到产品落地中的鸿沟,探索更适合工业级产品的端到端解决方案。 目前WeNet项目已经开源到 https…
随着技术的不断进步,使得我们每个人也越来越多地与Siri和Alexa等小工具互动。这些小工具现在也加入了Apple CarPlay和Android Auto等汽车助手的行列,甚至还有一些对语音生物特征识别敏感的应用程序。但是,设想一下,如果…
自18年谷歌BERT横空出世以来,预训练语言模型一跃成为自然语言处理领域的研究热点,海量数据与大规模模型的预训练+少量下游任务数据微调(Pre-training + Fine-tune)也成为NLP任务的新范式。 从在开源数据集上进行评测到…
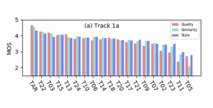
The Multi-speaker Multi-style Voice Cloning Challenge 2021是爱奇艺、北京希尔贝壳科技有限公司、西北工业大学音频语音与语言处理研究组、清华大学深圳国际研究生院、新加坡国立大学、起源智能…
今天(4月13日)凌晨,NVIDIA GTC2021如约而至。其中三款基于Arm IP打造的处理器尤为引人关注: NVIDIA Grace:专为大规模人工智能和高性能计算应用而设计; BlueField-3 DPU:首款支持第五代PCIe总…