语音识别(ASR)论文优选:SynthASR: Unlocking Synthetic Data for ASR

Streaming End-to-End ASR based on Blockwise Non-Autoregressive Models 本文为Johns Hopkins University在2021.07.20更新的文章,主要使用bl…
49 1 0

Streaming End-to-End ASR based on Blockwise Non-Autoregressive Models 本文为Johns Hopkins University在2021.07.20更新的文章,主要使用bl…
ASLP嗑盐君 音频语音与语言处理研究组 2019-08-29近期,实验室孙思宁、郭鹏程同学的论文“Adversarial Regularization for Attention Based End-to-End Robust Speec…
今天cv调包侠尝试了使用TensorRT 做YOLO的加速,先概述我这边实现的速度和精度对比: 精度上对比: 可以看到,精度上使用TensorRT 精度不掉,反而略微上升了一些些(具体情况未知,还在摸索)
语音合成工程师 AI技术部 [ 岗位职责 ] 语音合成的数据采集、研究和应用维护。 撰写相关技术文档和专利。 [ 任职要求 ] 深刻理解TTS原理,研究TTS2年以上,使用过主流端到端声学模型和合成器,如tacotron,wavernn,h…
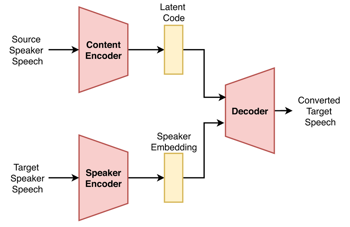
声音转换 声音转换(voice conversion, 简称 VC),定义:输入是一段人声 A (源说话人),输出是另外一段人声 B(目标说话人),A 和 B 说话内容相同,但是某些方面不一致。不一致的地方包含几个方面:音色不一致,情绪不一…
2021年7月24日,由CCF语音对话与听觉专委会 、AIIA 中国人工智能产业发展联盟评估组 、北京希尔贝壳科技有限公司、语音之家(北京)科技有限公司共同主办的【语音之家】AI技术沙龙——语音合成,成功举办! 【语音之家】AI技术沙龙第三…
语音合成或文语转换(Text to Speech, TTS)是指将文本转换为自然语音的一类技术。人类的语音具有灵活多样的特点,正如“世界上没有两片完全相同的叶子”一样,针对同样的文本,我们每次发出的语音都各有不同,形成了各种“风格”(sty…
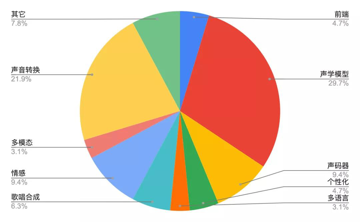
icassp2021 会议在2021 六月6~11日举行,一共录取1757篇(语音领域的会议录取文章真的多,记得搞体系结构和数据领域相关的会议录取也就几十篇或者百篇,可以很容易的看个大概。个人毕业后就没计划发过文章,究其原因,比较菜~~),…