
文本到音乐(TTM)技术作为 AI 音频领域的重要研究分支,近年来在技术落地与性能提升上实现了稳步发展,为音乐创作领域带来了新的可能性。与此同时,TTM 系统的评估问题始终是行业研究的重点与难点。现有客观与主观评估方法难以在性能与成本间达成平衡,且受限于音乐评估的专业性要求、文本与音乐关联的复杂性,评估结果往往难以精准匹配人类的真实感知。
为填补这一领域的研究空白,希尔贝壳联合南开大学正式开源首个“MusicEval 生成式音乐评分数据集”。该数据集整合了主流模型生成的音乐样本与专家专业评分,还配套了针对性的自动评估模型,为TTM 评估提供了全新的解决方案。
“MusicEval: A Generative Music Dataset with Expert Ratings for Automatic Text-to-Music Evaluation”已成功被国际顶级学术会议ICASSP 2025收录。
论文地址:
数据说明
MusicEval 数据集是一个生成式音乐评估数据集,总时长 16.62 小时,包含 2748 个单声道音乐片段,以及 14 位音乐专家给出的 13740 条评分。这些片段由 21 个不同的系统(涵盖 31 个模型)响应 261 条提示词生成。261条文本提示词包含80条人工撰写,20条来自MusicCaps数据集,这二者提供给模型生成音乐;其余161条仅对应提供样例的系统所生成的音乐片段。为保证数据一致性,所有音乐片段均为为16kHz 单声道格式。每个音乐片段均由来自音乐学院的 5 位音乐专家进行背靠背评估,专家基于整体音乐印象与文本提示的契合度两项标准进行打分。这两个维度分别聚焦音乐的质量本身,以及音乐与给定文本提示的一致性,为音乐生成模型的综合评估提供了关键基准。
团队构建了一个基于CLAP的面向文本生成音乐自动评估任务的基线模型。该模型通过对比语言音频预训练模型作为上游特征提取器,结合轻量级投影层分别预测整体音乐质量和文本一致性两个维度的分数,以人工专家评分作为监督信号实现对生成音乐质量的自动回归预测。
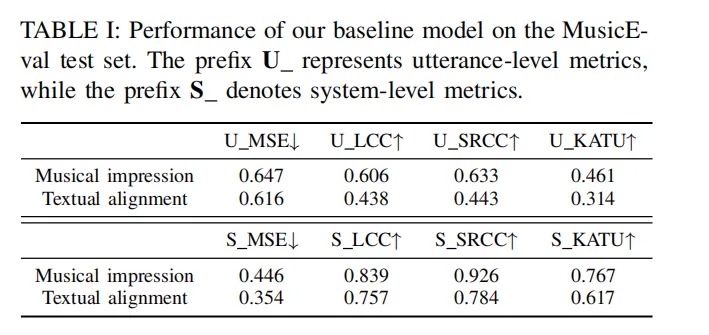
图1MusicEval测试集实验结果
实验结果表明,该基线模型在MusicEval测试集上,对于“整体音乐印象”维度的系统级线性相关系数为0.839、斯皮尔曼秩相关系数为0.926,对于“文本依从性”维度的系统级线性相关系数为0.757、斯皮尔曼秩相关系数为0.784,验证了在数据支撑下基于跨模态预训练表征对文本生成音乐进行自动质量评估的可行性。