
🚀 Emilia-Large核心亮点?
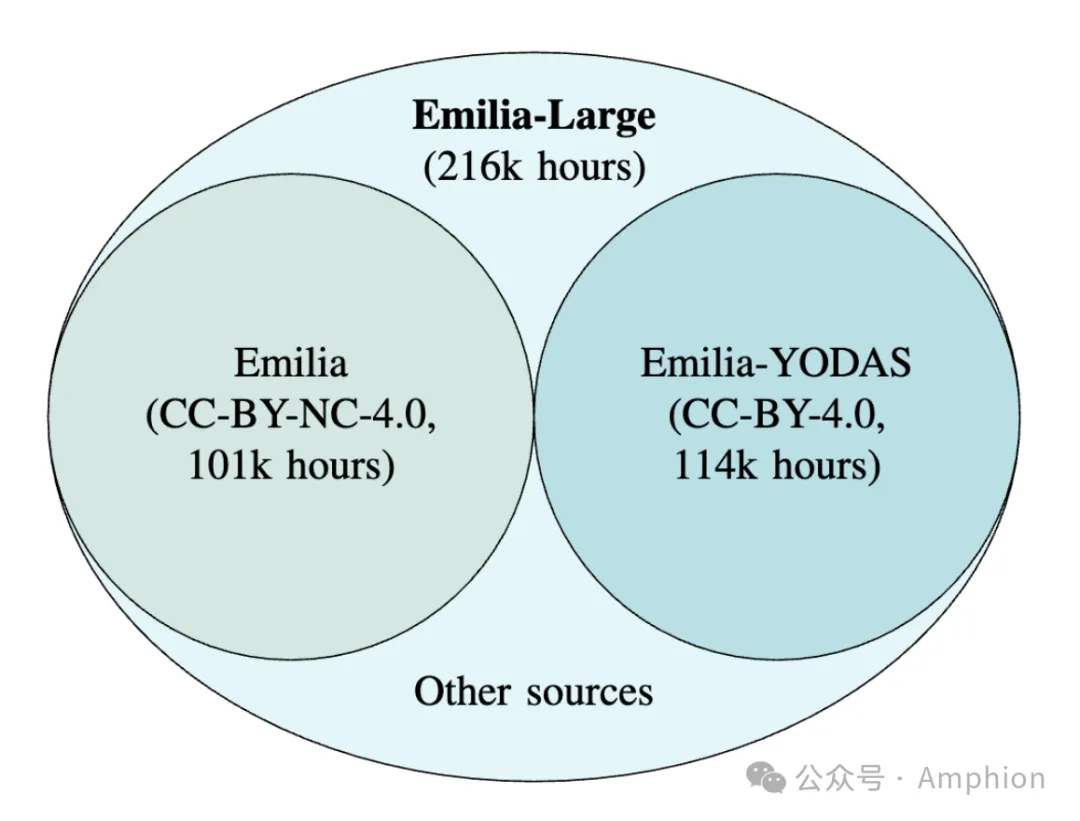
图:Emilia-Large 的数据分布
除了数据本身的升级,我们在相关论文中深入探讨了以下研究问题:
🔗 快速获取(HuggingFace 仓库)
已授权用户:曾申请过 Emilia 权限的研究者,可直接访问原仓库下载 Emilia-YODAS,无需重复申请! 新用户:访问 HuggingFace 页面,按 README 指引提交申请。
🎧技术资源
📌Emilia-Dataset: https://huggingface.co/datasets/amphion/Emilia-Dataset 📌Emilia-Pipe GitHub:https://github.com/open-mmlab/Amphion/tree/main/preprocessors/Emilia 📌论文:https://arxiv.org/abs/2501.15907