
官方网址:at-add.com
摘要
随着音频大语言模型(Audio Language Models, ALMs)的快速发展,创作者已经能够使用AI工具以较低成本生成高保真音频,音频内容丰富多样,除了基础的语音以外,还包括环境音、歌声和音乐等其他类型。这些能力在推动内容创作与生产的同时,也带来了严重的安全与信任问题——高质量的深度伪造音频已经可以被大规模生成与传播。在此背景下,音频深度伪造带来的风险日益凸显:其不仅可用于冒充身份、伪造语音指令实施诈骗,还可通过合成环境音制造虚假事件,误导公众认知并影响舆论传播。同时,随着歌声与音乐生成的发展,伪造音频还可能涉及版权侵权与内容操控。在更高风险场景中,该技术甚至可能绕过语音认证、操控智能设备,或用于伪造关键证据,对社会安全与信任体系构成威胁。
然而,现有的音频深度伪造检测(Audio Deepfake Detection, ADD)方法与评测体系仍主要集中于语音场景,且多基于相对理想化的实验条件构建,例如干净语音数据与有限的伪造类型。这与真实应用环境存在显著差距:现实场景中,音频往往由多种设备采集(如手机、车载设备、可穿戴设备等),并伴随噪声、混响、压缩等复杂干扰;与此同时,攻击手法与生成模型也在快速演进,覆盖更广泛的生成机制与音频类型。因此,现有方法在复杂环境下的鲁棒性以及面对新型伪造与多类型音频时的泛化能力仍然有限。
针对上述问题,我们发起了 ACM Multimedia 2026 全类型音频深度伪造检测挑战赛 AT-ADD(All-Type Audio Deepfake Detection),旨在连接理想化实验环境与真实多媒体取证场景,推动构建更加鲁棒、泛化的音频深度伪造检测技术。
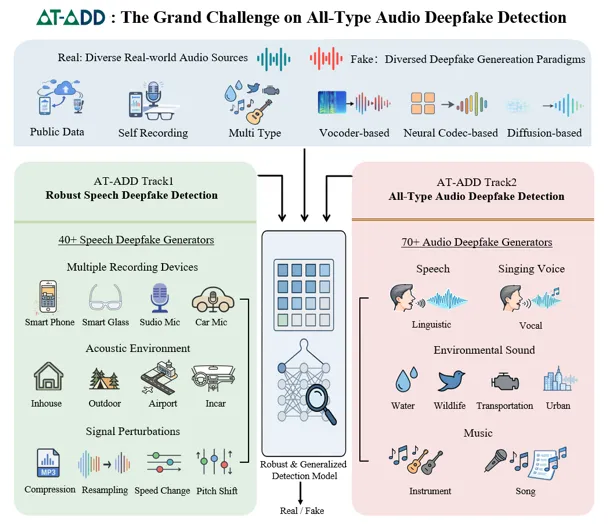
图1 AT-ADD挑战赛整体框架与任务设置
官方赛道设置
AT-ADD 包含两个子赛道:
(1)深度伪造语音鲁棒性检测(Robust Speech Deepfake Detection),重点评估模型在真实复杂声学环境及未见先进语音生成方法下的检测能力;
(2)全类型音频深度伪造检测(All-Type Audio Deepfake Detection),将检测任务从语音扩展至多种未知音频类型,推动模型在语音、环境音、歌声和音乐等多类型场景中的统一泛化能力。
赛道一:深度伪造语音鲁棒性检测
第一个赛道聚焦于真实世界语音伪造检测的鲁棒性问题。在该赛道中,我们构建了包含40余种语音生成模型的数据集 AT-ADD Track 1。真实语音部分由多个公开数据集与内部数据共同构成,覆盖多语种、多设备录制以及多样声学环境,包括手机、车载系统、智能眼镜以及不同类型麦克风等,同时叠加噪声、混响等复杂声学干扰,并进一步引入录音重放干扰,以更贴近真实应用场景中的多样化退化因素。伪造语音则涵盖40余种生成方法,系统性覆盖当前主流音频生成机制,包括语音合成、音色转换、音色克隆等,模型结构覆盖声学特征生成模型、声码器及语音生成大模型等。此外,我们进一步引入压缩、重采样、变速等信号级扰动,以模拟音频在真实通信与传播过程中的退化效应。该赛道旨在推动模型在复杂真实环境中的稳定性与跨域泛化能力,促使模型捕捉到更加本质且具有泛化性的伪造特征。
赛道二:全类型音频深度伪造检测
在赛道一的基础上,第二个赛道进一步扩展至全类型音频伪造检测问题。该赛道不再局限于语音,而是同时覆盖语音、音效、歌声和音乐四类音频,并要求模型在未知音频类型条件下完成统一的真实/伪造判断。为此,我们构建了包含70余种音频生成模型的数据集 AT-ADD Track 2。与赛道一不同,考虑到该任务首次系统性地探索全类型音频伪造检测问题,赛道二未引入额外的信号级扰动,以更清晰地研究模型跨类型泛化能力。真实音频由多个公开数据集组合构成,伪造音频则由我们基于不同生成机制统一合成,且不额外叠加噪声或其他干扰因素。该赛道的核心目标在于推动研究从“针对单一音频类型优化”转向“跨类型统一建模”,使模型能够捕捉不同音频形式中共享的伪造特征,从而提升其跨类型的泛化能力。
基线及评估
◆在基线方法方面,AT-ADD 提供了6种具有代表性的音频伪造检测模型,涵盖传统判别式方法与基于大模型的检测框架。具体而言,我们构建了两类传统鉴伪模型、两类基于自监督学习(Self-Supervised Learning, SSL)的鉴伪模型,以及两类基于音频大模型(Audio Large Language Model,ALLM)的监督微调方法,从而覆盖从轻量模型到大模型的不同研究范式。所有基线模型均在统一的训练与评估协议下进行实现,并提供完整的代码与配置文件,以支持结果复现与进一步研究。相关基线性能如表1所示。
◆在评估流程方面,挑战赛分为两个阶段。第一阶段为进展评估阶段,该阶段的评估集(progress set)由最终测试集(eval set)中按同分布抽取的20%构成,用于参赛者进行模型开发与调优;第二阶段为最终评估阶段,主办方将发布完整的测试集,参赛者需通过比赛平台提交预测结果以获得最终成绩。为保证评测公平性与防止过拟合,平台对每日提交次数进行限制。
◆在评测指标方面,Track 1 与 Track 2 均采用 Macro-F1 分数作为主要评价指标。相较于传统的等错误率评测,Macro-F1 要求模型输出明确的二分类结果(real/fake),更符合实际应用需求以及当前基于大模型的判别范式。最终分数由评测平台在后台统一计算。其中,Track 1 在整体数据上计算二分类的 Macro-F1 分数;Track 2 则在每种音频类型内分别计算 Macro-F1,并对四类结果进行平均,从而同时兼顾类别平衡与类型平衡。此外,我们在Track 2还将提供各音频类型的分项 F1 分数,以支持参赛者对模型在不同类别上的性能进行更细致的分析与优化。
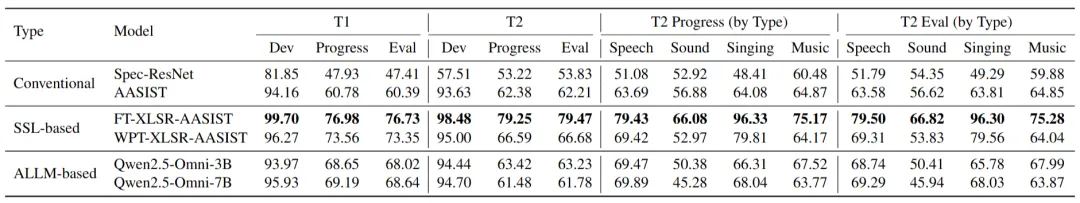
表1 基线模型在AT-ADD Track1和Track2的F1-score(%)表现
比赛安排
2026年4月10日:论文,基线代码,数据集下载开放 (暂定)
2026年4月11日:进展评估阶段提交开放
2026年6月11日:最终测试阶段提交开放
2026年6月18日:最终测试榜单冻结,最终排名确认
2026年6月25日:参赛论文提交截止
2026年7月16日: 论文录用通知发布
2026年8月1日: 论文终稿提交截止
综合排名前三的技术方案论文将被收录至 ACM MM 2026 主会论文集
组织单位
◆中国传媒大学
◆蚂蚁集团
◆中国科学院自动化研究所
◆北京理工大学
◆上海交通大学
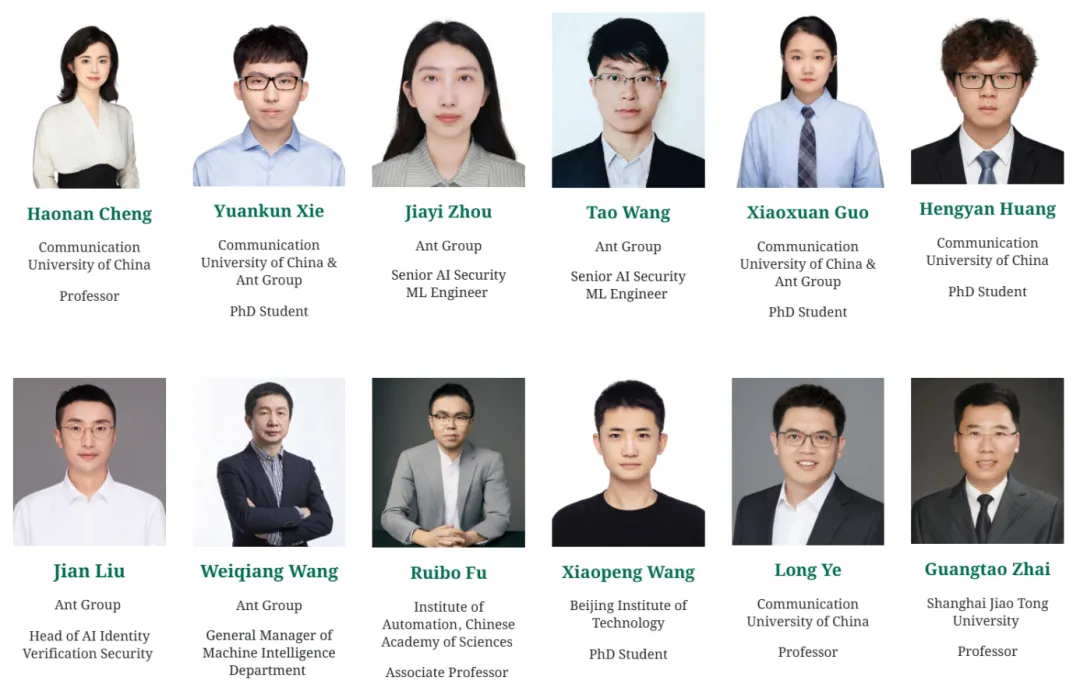
组织成员
联系方式
组织相关
Haonan Cheng (haonancheng@cuc.edu.cn)
Jiayi Zhou (zjy326112@antgroup.com)
技术相关
Yuankun Xie (xieyuankun@cuc.edu.cn)
Tao Wang (mengyu.wt@antgroup.com)