
第一视角理解是具身智能感知真实世界并执行复杂任务的关键能力。EgoLink (Egocentric Language-Vision Interactive Network Knowledge Challenge)旨在推动具身 AI 在复杂真实世界自我中心场景中的发展。超越传统的导航或静态物体感知,本挑战赛全面评估模型在社交推理和交互式任务执行方面的能力。它要求智能 AI 不仅能够感知情感线索、理解因果关系、预测人类互动中的行为意图,还能通过多模态对话、动态工具使用和自主规划来主动解决日常生活任务。EgoLink 致力于培养感知、推理和决策在非结构化社交环境中紧密耦合的集成智能。来自蚂蚁集团、浙江大学等机构的研究者共同发起了这一挑战赛,比赛目前已经开启报名,诚邀各位参加。
- EgoLink 2026 主页:https://ego-link.github.io/challenge2026
- 报名链接:https://docs.google.com/forms/d/e/1FAIpQLSeNAkMcjg5znInV8X8iVy6Jx3VK4L1vH0UgHkj-UY6X81iU5w/viewform
- 赛道1 训练集视频下载:https://github.com/Exploring-Embodied-Emotion-official/E3/blob/main/dataset/README.MD
- 赛道2 参赛指南:https://github.com/ego-link/egolink2026/blob/main/doc/track2/Track2_Evaluation_Submission_Guide_ZH.pdf
为什么要提出 EgoLink?
虽然具身 AI 的终极目标是从第一人称视角进行感知和交互,随着 AR/VR 设备、AI 眼镜和社交机器人的日益普及,理解以人为中心的社交互动已成为多模态研究的核心挑战。当前的多模态大模型在处理第一人称视频时面临着双重挑战:
- 挑战一:从视频描述到社交认知的跨越。尽管当前的多模态大模型在场景描述表现出色,但在第一人称视角中难以进行较长的因果推理和细粒度感情理解,无法真正理解第一人称视角的情感细节、社交因果关系和人际互动动态。
- 挑战二:从感知到行动的鸿沟。传统评测主要关注静态的视觉问答,而忽略了具身智能在真实社交场景中需要的感知-推理-决策-执行的完整闭环能力。模型不仅需要具备感知理解能力,还应当能够实现后续行动并完成最终任务。
EgoLink 的创新之处:
- 全面评估集成智能:评估情感感知、因果理解、意图预测、工具使用、自主规划等多维能力;
- 真实世界场景:基于真实的第一人称社交生活场景,包含智能眼镜数据录制;
- 感知-推理-行动耦合:在非结构化环境中实现端到端的紧密整合感知、推理和决策。
赛道设置
针对以上的双重挑战,EgoLink 2026设置了两个互补的赛道,分别评估模型的社交认知能力和交互执行能力。
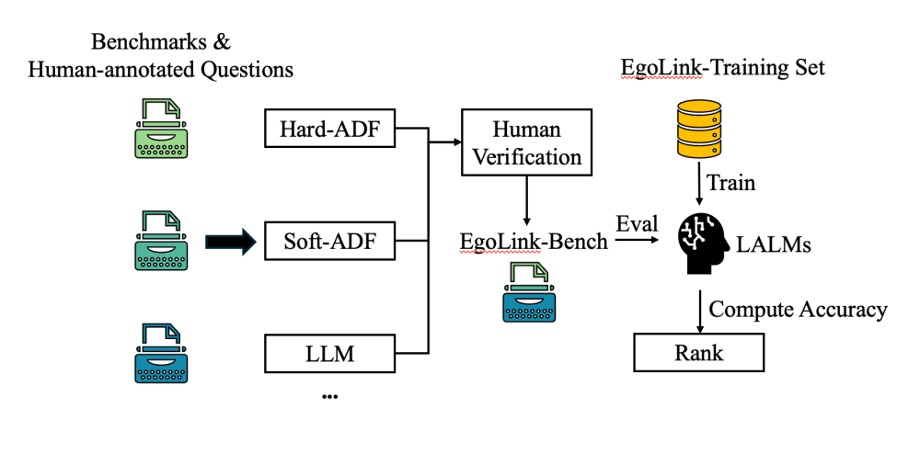
图1:Benchmark构造、训练和评估流程。
🏁赛道 1: 第一视角中的社交推理(Social Reasoning in Egocentric Video)
本赛道聚焦第一视角中的社交推理。不同于基础的测试导航或物体感知,该基准评估模型在真实人类互动场景中的情感感知、因果理解、行为意图预测和语义总结能力。挑战赛基于 E3(Exploring Embodied Emotion)数据集[1]构建,引入了统一的多项选择题,旨在提供客观、可复现且对多模态学习和具身 AI 社区都易于获取的评估标准。
核心评估维度:
1) 情感感知与定位(Emotional Perception and Localization)
- 识别第一人称视频流中的情感类别及其时间边界
- 精确定位情感的起止时间和持续时长
- 分析情感强度和情感变化轨迹
2) 社交因果推理(Social Causal Reasoning)
- 分析观察到的社交情感和反应背后的因果触发因素
- 理解社交线索(眼神、肢体语言、言语)与情感的因果关系
- 推断社交互动背后的深层动机
3) 行为意图预测(Behavioral Intent Prediction)
- 从多模态交互上下文中推断可能的未来意图和目标
- 基于当前行为和情感状态预测未来行为
- 理解行为背后的社交策略
4) 自我中心语义总结(Egocentric Semantic Summarization)
- 选择最能从自我视角捕捉社交情节的高层次总结
- 概括人际关系的类型和互动模式
- 提炼社交情节的情感基调和核心主题
🏁赛道 2: 交互式智能体挑战:社交生活场景中的多模态交互任务执行(Interactive Agent: Multimodal Interaction Task Execution in Social Life Scenarios)
本赛道评估智能体在复杂动态的社交生活环境中通过工具使用解决真实世界任务的能力。与传统的静态问答或单模态识别任务不同,本赛道要求模型作为交互式智能体。智能体接收第一人称视觉流(例如购物、点餐等高频日常场景),结合用户自然语言指令和可用的外部工具,通过多轮对话、精确的工具调用、自主规划和闭环执行来完成用户目标。除了视觉感知准确性,本赛道主要评估模型在非结构化环境中的集成智能,其中感知、推理和行动必须紧密耦合。本赛道不限制数据集。
核心评估维度:
1) 细粒度的自我中心视觉理解(Fine-grained Egocentric Visual Understanding)
智能体必须处理连续视频流或时序图像序列,以类人方式理解环境
- 时空感知:例如物体状态随时间的变化和相对空间关系
- 属性识别:例如颜色、形状、纹理和品牌线索
2) 动态工具调用与执行(Dynamic Tool Invocation and Execution)
智能体不仅要“回复”,还要“行动”
- 决定何时调用工具以及使用哪个工具
- 从实时视觉证据构建正确的输入参数(例如屏幕上的价格或菜单选项)
- 通过解释工具输出并选择下一步行动(完成、重试或切换策略)来闭环
3) 多跳逻辑推理与复杂决策(Multi-hop Logical Reasoning and Complex Decision Making)
对于模糊和复杂的真实世界用户请求,评估模型的高级认知能力
- 条件推理:“如果...那么...”约束
- 多引用解析:在长对话和多物体场景中(例如“红色的那个”或“我们之前看到的那个”)
重要时间(AOE时间)
🕖赛道1 时间表
| 时间节点 | 事项 |
| 2026.4.15 | E3视频数据集开放预下载 |
| 2026.4.25 | 开放报名 |
| 2026.6.8 | 测试集发布 |
| 2026.6.22 - 6.25 | 最终答案和报告提交窗口 |
🕖赛道2 时间表
| 时间节点 | 事项 |
| 2026.4.25 | 开放报名 |
| 2026.5.25 | 在线测试开放 |
| 2026.6.15 - 6.25 | 最终答案和报告提交窗口 |
诚挚邀请
本次挑战赛由全球多所高校与科技企业的专家联合发起,包括蚂蚁集团(AI身份智能团队)和浙江大学。ACM MM 2026 Grand Challenge: EgoLink 诚邀视频理解、多模态大模型、具身智能、社交智能领域的研究者与开发者共同参与,让我们一起探索 AI 在真实社交场景中的感知-推理-行动能力边界,推动具身智能体的集成智能发展!优秀参赛选手将被推荐技术报告至ACM MM 2026 主会议论文集(Main Conference Proceedings)。
立即访问:https://ego-link.github.io/challenge2026/
立即注册:https://docs.google.com/forms/d/e/1FAIpQLSeNAkMcjg5znInV8X8iVy6Jx3VK4L1vH0UgHkj-UY6X81iU5w/viewform
作者:ACM MM 2026 Grand Challenge EgoLink组织委员会
[1] Wang Lin, Yueying Feng, Wenkang Han, Tao Jin, Zhou Zhao, Fei Wu, Chang Yao, and Jingyuan Chen. E3 : Exploring Embodied Emotion Through A Large-Scale Egocentric Video Dataset. Advances in Neural Information Processing Systems (NeurIPS), Datasets and Benchmarks Track, volume 37, 2024.