
分享一场Interspeech 2025的赛事:Multimodal Information Based Speech Processing (MISP) 2025 Challenge。该赛事重点关注多模态多设备会议转录,旨在通过引入额外的模态信息(特别是视频模态)来突破当前技术的界限,并设有奖金。欢迎大家踊跃报名参加!
赛事网址:https://mispchallenge.github.io/mispchallenge2025
比赛概述
近年来,语音驱动的应用程序迅速发展,其使用场景变得愈加复杂,例如家庭环境和专业会议。这些场景由于恶劣的声学条件(如远场音频、背景噪声和混响)而面临巨大的挑战。麦格克效应(McGurk effect)表明视觉对人类听觉感知具有显著影响,后续研究进一步证实,视觉线索(如唇部运动)能够在嘈杂环境中提升语音感知效果。受此启发,多模态信息语音处理(MISP)挑战赛致力于通过引入额外的模态信息(如视频)来突破当前语音处理能力的限制。
此前的MISP 2021、2022和2023挑战赛以家庭场景为目标,数据来源为多人在客厅观看电视时的中文对话。为支持多项任务的研究,这些挑战赛发布了一个大规模的音频-视频中文家庭对话语料库,包括音视频唤醒词检测、音视频目标说话人提取、音视频说话人分离以及音视频语音识别等任务。MISP2021、2022和2023挑战赛吸引了全球研究社区的广泛参与,累计超过150支团队下载数据集,60多支团队积极提交研究结果,已有15篇相关研究论文在ICASSP 2022、2023和2024上发表。
会议是语音应用中最具价值但也最具挑战性的场景之一。其信息交流和决策过程丰富,因而准确的会议转录和内容分析对于提升生产力和保存关键信息至关重要。然而,会议转录任务因多样的语音风格和复杂的声学环境而面临诸多挑战。MISP 2025挑战赛聚焦于多模态多设备的会议转录,旨在通过引入额外的模态信息(特别是视频模态)推动当前技术的发展。
本次挑战赛的具体任务包括:
- Audio-Visual Speaker Diarization
- Audio-Visual Speech Recognition
- Audio-Visual Diarization and Recognition
MISP 2025挑战赛将提供以下资源:
- 发布一个大规模的音视频会议语料库(MISP-Meeting)以及基线系统。
- 提供一个公开基准,用于公平比较。
- 发表总结性论文,展示最有效的技术和前沿方向。
MISP-Meeting语料库
如图 1 所示,会议参与者围坐在配备有8麦克风阵列和全景摄像头的桌子旁,这些设备均放置在标准会议室内。参与者以自然对话的形式讨论各种话题,包括医疗、教育、商业和工业生产等。在会议过程中,不同类型的室内噪声(如鼠标点击声、键盘敲击声、门的开启与关闭声以及风扇声)会自然地出现。此外,每位参与者均佩戴头戴式麦克风,用于采集近场语音数据。
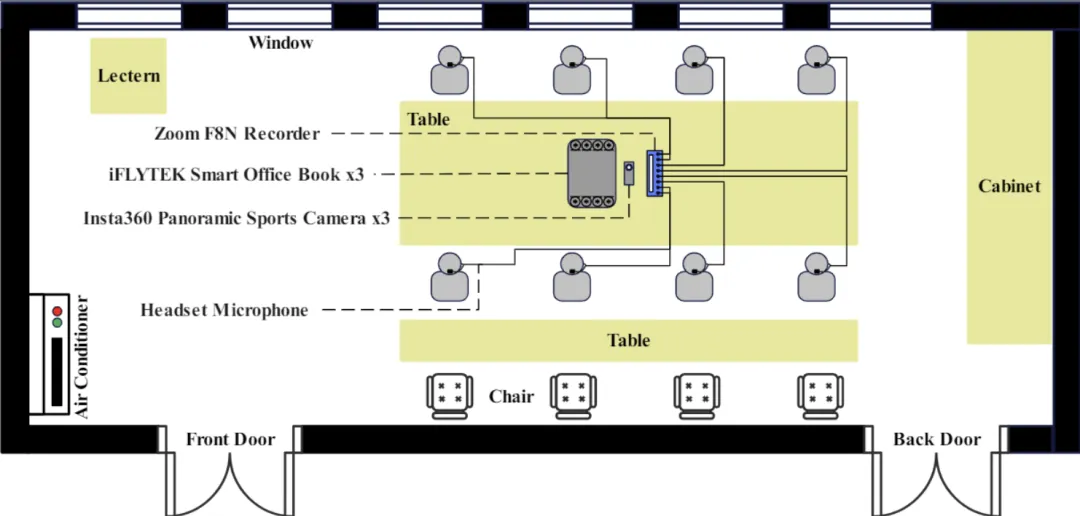
图1. 录制场地及所使用设备的示例
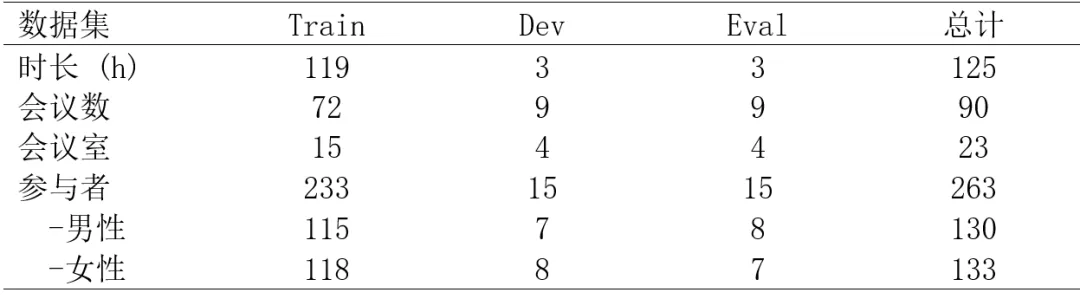
如表 1 所示,MISP-Meeting语料库总共涵盖125小时的音频和视频数据。数据集被划分为训练集(Train)119小时、开发集(Dev)3小时和评估集(Eval)3小时,用于挑战任务的评分与排名。训练集、开发集和评估集分别包含72个、9个和9个会话。这些子集之间的说话人和录制房间完全不重叠。每个会话由4至8名参与者的讨论组成。讨论时长根据数据集有所不同:训练集中的每个会话持续2小时,而开发集和评估集中的会话则为20分钟。因此,训练集中的会话包含多个话题转换。训练集、开发集和评估集的参与者总人数分别为233人、15人和15人,性别比例平衡。所有参与者的职业或(如果是学生)学习领域均与会议主题相关。这种现实背景不仅增强了场景的真实性,还有效减少了讨论中的长时间静默现象。
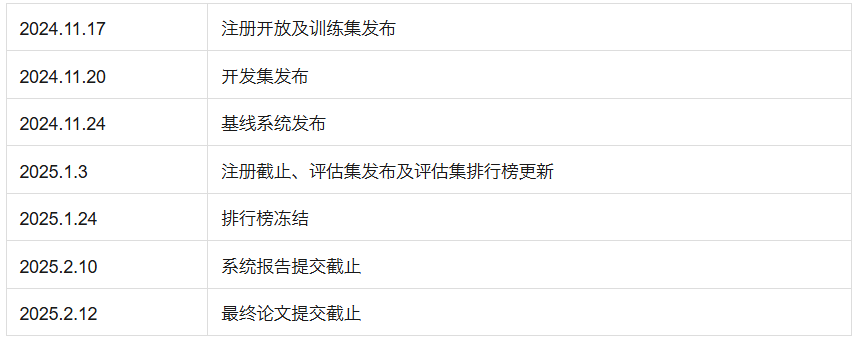
计划的时间线
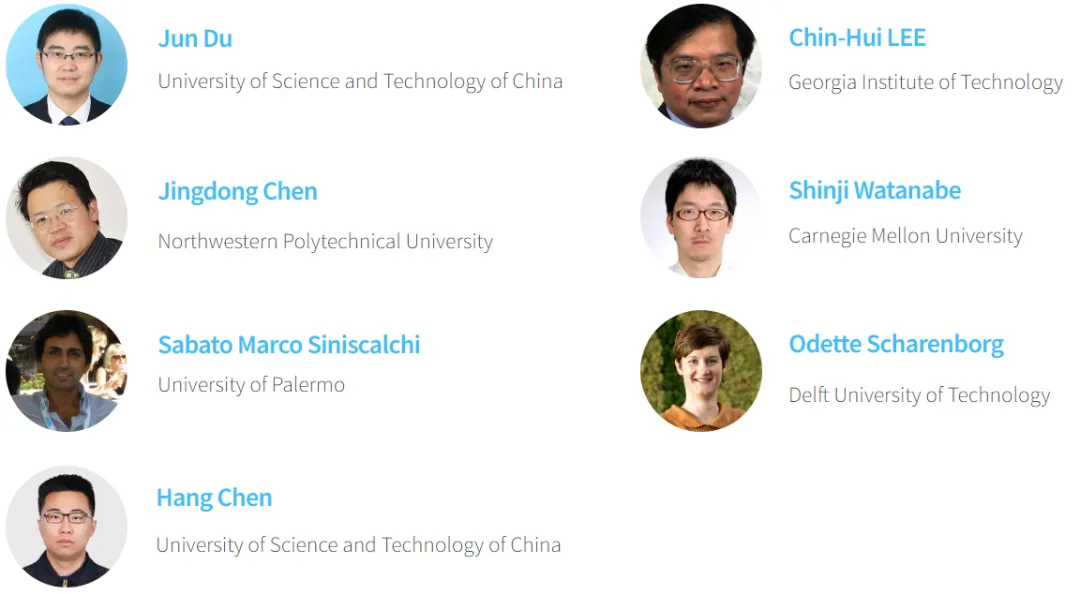
组织者
奖金
任务1、任务2和任务3的提交结果将分别使用Diarization Error Rate(DER)、Character Error Rate(CER)以及Concatenated Minimum-Permutation Character Error Rate(cpCER)进行评估。在任务1中,DER值越低的结果将在排行榜中排名越高。同理,任务2和任务3中,CER值和cpCER值越低的系统将在相应排行榜中获得更高排名。
排行榜冻结后,主办方将对提交的系统报告进行审核,以确认最终排名。最终,在三个任务中排名第一的团队将分别获得5000美元奖金。
注册报名
👆
扫上方二维码报名参加