ASRU 2025 | SEF-MK: 通过多K-Means量化实现“去说话人特征嵌入”的语音匿名化

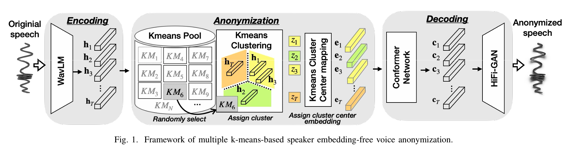
语音匿名化(Voice Anonymization)旨在在保留语义和情感信息的同时去除说话人的身份特征。现有基于深度学习的主流方法通常依赖显式说话人嵌入模型(Speaker Embedding Model)来提取和替换说话人特征,但这类方法…
23 0 0

语音匿名化(Voice Anonymization)旨在在保留语义和情感信息的同时去除说话人的身份特征。现有基于深度学习的主流方法通常依赖显式说话人嵌入模型(Speaker Embedding Model)来提取和替换说话人特征,但这类方法…