
声浪

通义最新发布语音双模型,一句话即可自由生成!

在传统语音生成中,表达方式往往依赖预设标签,例如: 固定情绪选项 预定义语气类别 限定风格模板 用户只能在有限选项中选择,而难以进行更自由、细腻的表达控制。 FreeStyle 新范式的核心突破在于 不再依赖固定标签,而是支持通过自然语言指…
29 0 0
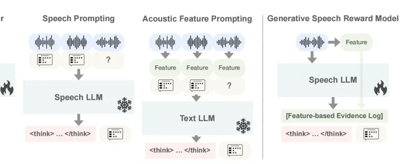
从 “能说话” 到 “会说话”:Meta+MIT 联手打出 GSRM “声学 + 推理” 组合拳,合成语音自然度赢率飙升 82%
以下文章来源于AI随想录,作者William 论文标题: GSRM: Generative Speech Reward Model for Speech RLHF 论文链接: https://arxiv.org/pdf/2602.13891…
21 0 0
谷歌Gemini 3.1 Pro增加音乐生成功能
来源丨新智元、AI音频时代 谷歌在 7.5 亿月活的 Gemini 中上线了 AI 音乐生成功能,输入一句话或一张照片,几秒就能得到一首带人声和歌词的完整歌曲。背后是 DeepMind 最新的 Lyria 3 模型,训练数据超 200 万首…
16 0 0