
声浪

哥大&Facebook开发AI新框架,多模态融合,音视频信息转换更强大!
Facebook、哥伦比亚大学、佐治亚理工学院和达特茅斯大学的研究人员共同开发了一个框架——Vx2Text。这个框架可以帮助我们,从视频、音频等输入内容中提取信息,再以人类可以理解的文字,生成字幕或者回答问题等。 论文地址:https://…
119 5 0
3人半年打造语音识别引擎——58同城语音识别自研之路
大多数人会认为研发语音识别技术是一条艰难的道路,投入会巨大,道路会很漫长。我们于2019年11月组建了3人团队自主研发语音识别技术,包括2名算法工程师和1名后端工程师,历经半年,自研语音识别引擎效果超过第三方采购厂商,成功打造了58语音识别…
159 5 0
出门问问联合西北工业大学推出端到端语音识别工具WeNet
近日,出门问问联合西北工业大学音频语音与语言处理研究组推出面向产品和工业界的端到端语音识别开源工具WeNet,WeNet致力于消除从端到端模型研究到产品落地中的鸿沟,探索更适合工业级产品的端到端解决方案。 目前WeNet项目已经开源到:ht…
362 7 0
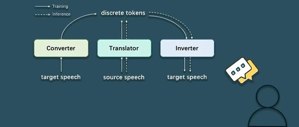
AAAI 2021 | 不依赖文本也能做翻译?UWSpeech语音翻译系统了解一下
语音到语音翻译已经被越来越多地应用在人们的日常生活和工作中。但是目前的语音翻译系统高度依赖于语音对应的文本,不能应用于如方言、少数民族语言等没有文字的语言。为此,微软亚洲研究院提出了语音翻译系统 UWSpeech,该系统可针对没有文字的语言…
11 0 0
浅谈MFCC/HMM/GMM/EM/LM
说起语音识别,大家的第一反应就是那些看起来眼熟却总也搞不清楚的概念和公式,比如MFCC、HMM、GMM、Viterbi图、解码对齐等等,再往下深入,哪个是哪个,具体用途是什么,就都说不清楚了,总觉得那得是业内大牛才能搞懂的。去网上搜索,各种…
191 0 0
10小时训练数据打造多语种语音识别新高度
在刚刚结束的NIST OPENASR评测中,TEG AI语音联合清华大学,刷新世界小语种语音识别比赛6项第一。从2000年开始,NIST组织的RT(英文语音识别),LRE(语音语种识别),SRE(语音说话人识别),OPENKWS(语音关键词…
25 0 0
论文分享:级联式RNN-T—基于音节与音字转换器的流式中文语音识别
近期,实验室王雄、姚卓远、石宪同学的论文“CASCADE RNN-TRANSDUCER: SYLLABLE BASED STREAMING ON-DEVICE MANDARIN SPEECH RECOGNITION WITH A SYLLA…
19 0 0
语音识别中的WFST和语言模型
在语音识别系统中,有限加权状态转换机(Weighted Finite State Transducers, WFST)扮演着重要角色。本文主要介绍发音词典、语言模型和WFST的原理,以及在实践过程中的一些优化方法。
175 0 0