ASR工业级代码-WeNet代码逐行分析(3)Encoder的forward
目前的位置 开始训练! 一个batch已经组装好了,开始进入训练 目前的代码位置: > /workspace/asr/wenet/wenet/utils/executor.py(43)train() 42 import ipdb; ipdb…
141 0 0

目前的位置 开始训练! 一个batch已经组装好了,开始进入训练 目前的代码位置: > /workspace/asr/wenet/wenet/utils/executor.py(43)train() 42 import ipdb; ipdb…
填坑cmvn cmvn : 计算mean, variance, count of frame这三个量。上次并没有详细分析计算cmvn的细节,这里把这个坑填了。 启动准备 tools/compute_cmvn_stats.py
本文目的是彻底摸清WeNet这个神作的细节,对于一些模棱两可的印象纠偏。我这次学习的版本是自己folk的:https://github.com/Xianchao-Wu/wenet 准备工作 老样子,先交代一下我用的docker,我还是随便找…
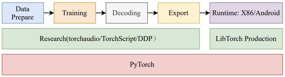
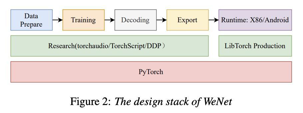
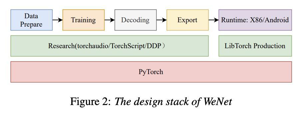
前文介绍了端到端识别的基本概念,本文介绍Wenet中模型的设计与实现。 Wenet的代码借鉴了Espnet等开源实现,比较简洁,但是为了实现基于chunk的流式解码,以及处理batch内不等长序列,引入的一些实现技巧,比如cache和mas…
作者:朱鹏程 近日,由网易伏羲语音与音乐团队、上海视觉艺术学院流行音乐舞蹈学院王玉老师团队、西工大音频语音与语言处理研究组谢磊老师团队、同济大学设计创意学院吴洁老师团队联合发布的中文精标歌声合成数据集Opencpop,正式在wenet开源社…
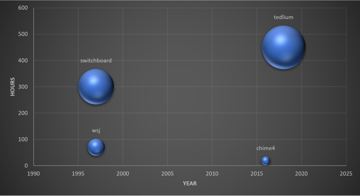
为进一步方便大家使用 WeNet 进行学术研究,近日,WeNet 在原有 LibriSpeech 和 GigaSpeech 两个主流英文数据集的基础上,新增如下四个英文数据集的支持: chime4 switchboard tedlium3…
本周,WeNet 新增首个日语数据集 csj 的支持。该工作由吴先超博士贡献,以下是更新的具体内容。 吴先超,博士毕业于东京大学。目前就职于 NVIDIA Japan,任深度学习资深架构师,负责 Finance + NVIDIA AI、Ge…
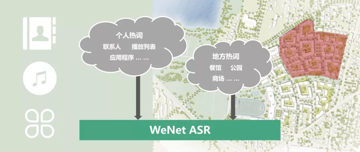
在语音识别的实际应用中,对于常用的词汇识别效果比较好,但是对于一些特有的人名、歌名、地名或者某个领域的专有词汇,例如人名宋星辰、歌名国际歌、地名丽泽商务区以及语音识别专业词汇解码器,可能存在识别准确率不高的情况。对于这些专有词汇,通过在 W…
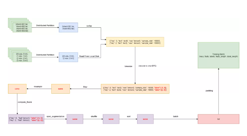
近日,WeNet 中更新了超大规模数据 UIO (Unified IO) 支持,可以支持工业级千万小时级别的语音数据训练,支持云存储 OSS/S3/HDFS 等,并且训练速度更快,接口更简单,更容易使用和调试。 旧有 IO 方案的问题 We…
日前,西北工业大学音频语音和语言处理研究组(ASLP Lab)、出门问问、希尔贝壳联合发布1万小时多领域中文语音识别数据集 WenetSpeech,在腾讯会议天籁实验室、华为昇思 MindSpore、 西安未来人工智能计算中心等机构大力支持…