PersonaTalk:无需训练即可创建数字人,视频口型编辑超SOTA

字节发布的PersonaTalk模型,可精准给视频进行AI配音的。该方案能不受原视频质量的影响,保障生成视频质量的同时兼顾 zero-shot 技术的便捷和稳定,可以通过非常便捷高效的方式用语音修改视频中人物的口型,完成高质量视频编辑,快速…
30 0 0

字节发布的PersonaTalk模型,可精准给视频进行AI配音的。该方案能不受原视频质量的影响,保障生成视频质量的同时兼顾 zero-shot 技术的便捷和稳定,可以通过非常便捷高效的方式用语音修改视频中人物的口型,完成高质量视频编辑,快速…


为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期分享一篇被NeurIPS2024接收的关于零样本对话语音生成方面的文章。 论文标题:Cross D…

来源丨新智元 最近,来自上海大学、山东大学和埃默里大学等机构的研究人员首次提出了文本边图的数据集与基准,包括9个覆盖4个领域的大规模文本边图数据集,以及一套标准化的文本边图研究范式。该研究的发表极大促进了文本边图图表示学习的研究,有利于自然…

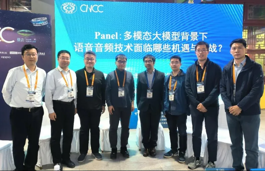
2024年10月24日下午,由中国计算机学会(CCF)语音对话与听觉专委会组织的CNCC技术论坛“多模态大模型时代的语音音频技术:带来哪些机遇与挑战?”在浙江省东阳市横店圆明新园成功举办。CCF语音对话与听觉专委秘书长、中国科学技术大学凌震…

来源丨机器之心 随着人工智能技术的快速发展,大型语言模型(LLMs)在自然语言处理、计算机视觉和科学任务等领域取得了显著进展。然而,随着模型规模的扩大,如何在保持高性能的同时优化资源消耗成为关键挑战。为了应对这一挑战,腾讯混元团队率先采用混…