

声浪

邱锡鹏团队开源MOSS-TTSD!百万小时音频训练,突破AI播客恐怖谷

来源丨机器之心 当前的文本到语音(TTS)模型在单句或孤立段落的语音生成效果上取得了令人瞩目的进展,合成语音的自然度、清晰度和表现力都已显著提升,甚至接近真人水平。不过,由于缺乏整体的对话情境,这些 TTS 模型仍然无法合成高质量的对话语音…
44 0 0

李宏毅与NVIDIA 联手打造 DeSTA2.5-Audio:证明旧方法正在“毁掉”你的语音语言模型
论文标题:DeSTA2.5-Audio: Toward General-Purpose Large Audio Language Model with Self-Generated Cross-Modal Alignment Arxiv:h…
56 0 0

IEEE TASLP|利用LLM改进口音语音识别的多模态多粒度生成式纠错与混合LoRA专家方法
语音识别(ASR)作为可以准确高效转录语音的技术,在当今社会中扮演着越来越重要的角色。当前语音识别已经取得了长足进步,但是当遇到不利语音条件时,识别错误率急剧升高。口音是说话人受到教育背景、地域或母语影响而偏离标准发音规范的情况,在现实世界…
32 0 0


Step-Audio 2:端到端音频大语言模型,实现行业级理解与对话能力
Step‑Audio 2是由StepFun团队开发的多模态大语言模型,可直接从原始音频输入理解语义与副语言信息,并生成连贯的文本与音频响应。 模型通过隐向量音频编码器、强化学习(RL)与检索增强生成(RAG)机制,引入工具调用(如 Web…
42 0 0

声网发布新版对话式 AI 引擎,三大创新功能重塑人机交互体验
近日,声网在2025世界人工智能大会发布新版对话式 AI 引擎,该版本新增声纹识别、数字人与视觉理解三项功能,实现对话式 AI 音视频交互体验的全新升级。同时,口袋 AI 毛绒宠物—芙崽 Fuzozo、家庭陪伴机器人—赋之 EBO Air…
40 0 0

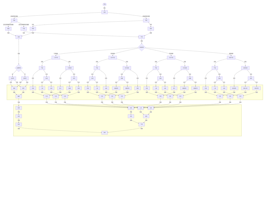
音元分析流程
```mermaid graphTB A([开始])-->|输入|B[音节] B-->|析取音节的音调|C1[节调] B-->|析取音节的音质|C2[节质] C1-->|切分与声母联结的调段|D1[首调] C1-->|切分与声母联结的调段|…
72 1 1
