
完全透明开源的共情语音大模型,三阶段训练,四大模块实现端到端对话

紫东太初团队联合长城汽车AI Lab推出完全透明开源的端到端共情语音语言大模型OpenS2S。 论文地址:https://arxiv.org/pdf/2507.05177 Demo地址:https://casia-lm.github.io/…
52 0 0

紫东太初团队联合长城汽车AI Lab推出完全透明开源的端到端共情语音语言大模型OpenS2S。 论文地址:https://arxiv.org/pdf/2507.05177 Demo地址:https://casia-lm.github.io/…

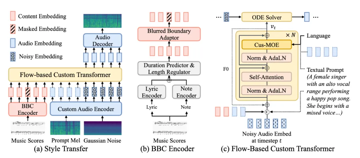
零样本歌声合成(SVS)旨在基于音频或文本提示,生成具有未见过的多级别风格的高质量歌声。该领域在专业音乐创作和短视频配音方面具有广泛的潜在应用。尽管传统的歌声合成任务已经取得了显著进展,但人们对更具定制化的体验需求日益增长。这不仅包括通过音…

近年来,神经网络偏置(Deep Biasing)方法在上下文语音识别(Contextual ASR)任务中取得了显著进展,其旨在提升模型对实体名称、技术术语等罕见短语的识别能力。当前主流方法多基于浅融合或神经网络偏置技术,将上下文短语中的子…


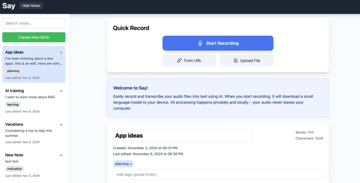
语音转文字(STT)常需云端处理或复杂软件安装,隐私和便利性难以兼得。 Say是一款基于Whisper和Transformers.js的开源浏览器内语音转文字工具,完全本地运行,保护隐私,同时提供实时转录和富文本编辑。 其核心特点包括 •浏…

近日,阿里通义实验室开源了旗下首个音频生成模型ThinkSound,该模型首次将CoT(Chain-of-Thought,思维链)应用到音频生成领域,让AI可以像专业音效师一样逐步思考,捕捉视觉细节,生成与画面同步的高保真音频。 目前,Th…

流式语音识别(streaming ASR)因其低延迟、高效率的特点,适用在诸多“快速出字”的应用中。当前主流的端到端模型包括 CTC、RNN-T 和基于注意力的编码器-解码器(AED)。其中 CTC 凭借结构简单,在流式场景中被广泛采用。为…
