
声浪

千问发布ASR模型 Qwen-Audio-3.0-ASR-Flash,长音频不丢词,行业词不用教

今天,千问发布语音识别大模型Qwen-Audio-3.0-ASR-Flash。简单来说,就是让AI更好地听懂专业词汇。这次主要在上下文一致性、行业词识别和热词定制化三个维度做了系统性的优化,同时让模型具备语音润色能力,可直接输出结构化文本。…
33 0 0
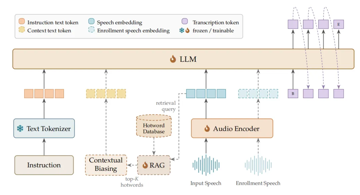
AmphionASR:“懂”场景支持大规模热词的个性化语音识别
本文来源:Amphion 如果把语音识别比作一场"听力考试",传统的ASR模型就像只准备了"标准普通话朗读"这一道题的考生。而现实中的语音场景远比“听写”复杂:会议室里多人同时发言、街头嘈杂环境中的通话、医生在病房里的低声交流、客服电话中的…
31 0 0
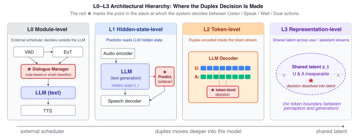
万字长文详解全双工口语对话系统综述:架构层级、交互本体与决策状态机
本文来源:乐百一家 论文题目:A Survey of Full-Duplex Spoken Dialogue Systems: Architectural Hierarchy, Interaction Ontology, and Decis…
52 0 0
开源项目|Agent Presence:开源实时语音框架 Qwen-Audio-Agent 来了
从《Her》里的温柔陪伴,到《普罗米修斯》里冷静执行任务的 David,再到《钢铁侠》里能理解上下文、调度系统、辅助决策的贾维斯,科幻作品一直在想象同一个问题: 真正自然的人机协作,应该是什么样子? 它不应该只是聊天框里的命令输入,也不应该…
37 0 0
缓解 TTS 的重复与漏读:用注意力引导消除语音合成中的稳定性幻觉
近年来,基于大语言模型的语音合成技术快速发展。在普通文本上,模型已经能够稳定生成自然度很高、音色也足够相似的语音。然而,一旦遇到复杂生僻词、排比句或连续重复结构,重复、漏读甚至无限循环等稳定性幻觉仍然可能出现。 这背后有一个基础问题: 语音…
33 0 0
语音对话里的轮次判断:从级联到统一
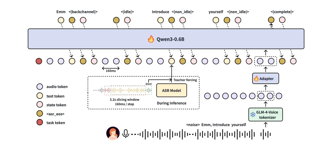
本文来源:听见未来Tech 全双工(full-duplex)语音交互要求系统在用户说话的同时并行完成识别、理解与响应决策,其核心难点在于判断当前话轮是否结束——决定何时接话、何时继续等待。传统 VAD(Voice Activity Dete…
46 0 0
当机器人开始全面认真倾听:音频具身智能综述来了
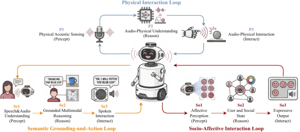
本文来源:SV4GoodAIlab 论文题目:Audio Embodied Intelligence: Auditory Perception, Reasoning, and Interaction for Multimodal Agent…
47 1 0