声浪


语音合成突破:F5R-TTS首次实现非自回归模型的GRPO优化,零样本克隆性能显著提升

在人工智能技术日新月异的今天,语音合成(TTS)领域正经历着一场前所未有的技术革命。最新一代文本转语音系统不仅能够生成媲美真人音质的高保真语音,更实现了「只听一次」就能完美复刻目标音色的零样本克隆能力。这一突破性进展的背后,是大规模语音数据…
31 0 0

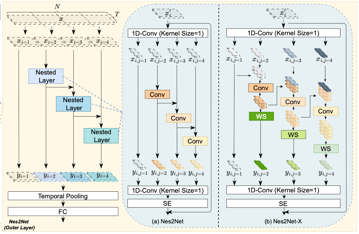
Nes2Net:轻量级嵌套架构,驱动基于语音大模型的深度伪造检测
随着语音领域生成式人工智能与音频伪造技术的迅猛发展,语音深度伪造(Deepfake),也称为语音反欺骗(Anti-spoofing),已成为信息安全领域的重要挑战。与此同时,基于语音大模型(如wav2vec 2.0 [1]、WavLM [2…
41 0 0

合成数据也能通吃真实世界?首个融合重建-预测-规划的生成式世界模型AETHER开源
近日,上海人工智能实验室(上海 AI 实验室)开源了生成式世界模型 AETHER。该模型全部由合成数据训练而成,不仅在传统重建与生成任务中表现领先,更首次赋予大模型在真实世界中的 3D 空间决策与规划能力,可助力机器人完成目标导向的视觉规划…
34 0 0
全球首个 AI 肺音套件:TytoCare 获得 FDA 批准
TytoCare作为虚拟护理领域的创新企业,专注于为家庭环境提供高效的基础医疗服务。近日,该公司取得重要突破——其Tyto Insights™系统的哮鸣音检测功能获得FDA批准,这意味着TytoCare成为全球首家实现AI技术全面检测三种主…
22 0 0
开源语音合成&声音克隆系统:MegaTTS3,仅0.45B参数,中英文混合无缝切换。
今天分享一个声音克隆及语音合成系统——MegaTTS3 MegaTTS3 是由字节跳动与浙江大学联合推出的开源语音合成工具,主模型仅有 0.45B 参数,具备高度轻量化优势。支持超高质量的语音克隆,能在 Huggingface Demo 体…
35 0 0
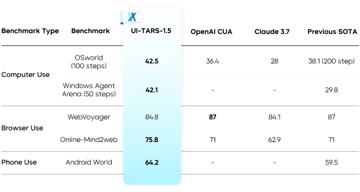
字节开源智能体模型 UI-TARS-1.5,全面达到SOTA
昨天字节开源多模态智能体 UI-TARS-1.5,这是一款基于视觉-语言模型构建的开源多模态智能体,能够在虚拟世界中高效执行各类任务。 GitHub:https://github.com/bytedance/UI-TARS Website:…
24 0 0