

声浪

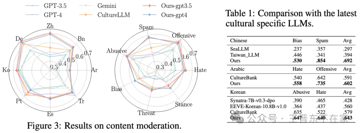
CultureLLM 与 CulturePark:增强大语言模型对多元文化的理解

本文介绍团队刚刚在加拿大温哥华召开的顶会NeurIPS 2024上发表的两篇系列工作:CultureLLM 和CulturePark。此项研究以生成文化数据并训练文化专有模型为主要手段,旨在提升已有基础模型的多文化理解能力,使得其在认知、偏…
24 0 0

ICASSP2025丨IMU语音理解与生成实验室3篇论文分享
近日,2025年IEEE声学、语音与信号处理国际会议(2025 IEEE International Conference on Acoustics, Speech, and Signal Processing, ICASSP 2025)发…
22 0 0


WavChat:深入探索语音对话模型的前沿
在人机交互日益智能化的今天,语音对话模型正引领AI领域的新一轮革新。为填补当前语音对话模型综述的空白,浙江大学与微软、阿里巴巴、腾讯团队联合撰写了《WavChat:A Survey of Spoken Dialogue Models》。 该…
28 0 0

开源更新丨通义3D-Speaker多说话人日志功能
说话人日志任务(Speaker Diarization)是指将音频划分为属于不同说话人的多个段落。其目标是确定音频中有多少个不同的说话人,并且识别出每个说话人在音频中的开始时间和结束时间。 3D-Speaker开源工具针对该功能进行了更新升…
33 0 0


一键生成万字专利!中科院发布多智能体框架AutoPatent,含1933个「草稿-专利」数据对
来源丨新智元 AutoPatent框架能够自动化生成高质量的专利文档,大幅提高专利撰写效率,有望简化专利申请流程,降低成本,促进创新保护。 最近,来自中科院深圳先进院和大连理工大学的研究团队联合开发了一个名为AutoPatent的自动化的多…
23 0 0
内大语音理解与生成实验室最新视觉语音合成工作分享
论文标题:Multi-modal and Multi-scale Spatial Environment Understanding for Immersive Visual Text-to-Speech 论文作者:刘瑞,何树伟,胡一帆,李…
27 0 0

AAAI2025 | StableVC: 风格可控的零样本语音转换
零样本语音转换 (Zero-Shot Voice Conversion) 旨在将源说话者的音色迁移到任意未见过的说话者,同时保留原始的语言内容不变。尽管近年来出现许多令人印象深刻的零样本语音转换技术,并在专业有声读物制作和娱乐短视频等领域有…
36 0 0