
在大模型席卷自然语言处理与语音领域的今天,预训练(Pre-training)赋予了模型强大的通用能力。然而,如何让这些“通才”在真实世界中更安全、更可控、更具逻辑?答案在于——后训练(Post-Training)。欢迎大家关注并投稿Interspeech 2026特别议题:Post-Training of Speech Foundation Models。
近年来,语音基座模型(Speech Foundation Models)通过在海量数据上的预训练,展现了惊人的泛化能力 。然而,预训练仅仅是第一步。在迈向真实世界部署的过程中,我们面临着诸多挑战:模型往往缺乏对特定领域(如儿童语音、病理语音)的细微理解,且难以完全内化安全、公平等伦理规范。后训练(Post-Training) 正是为了跨越这一鸿沟而生。
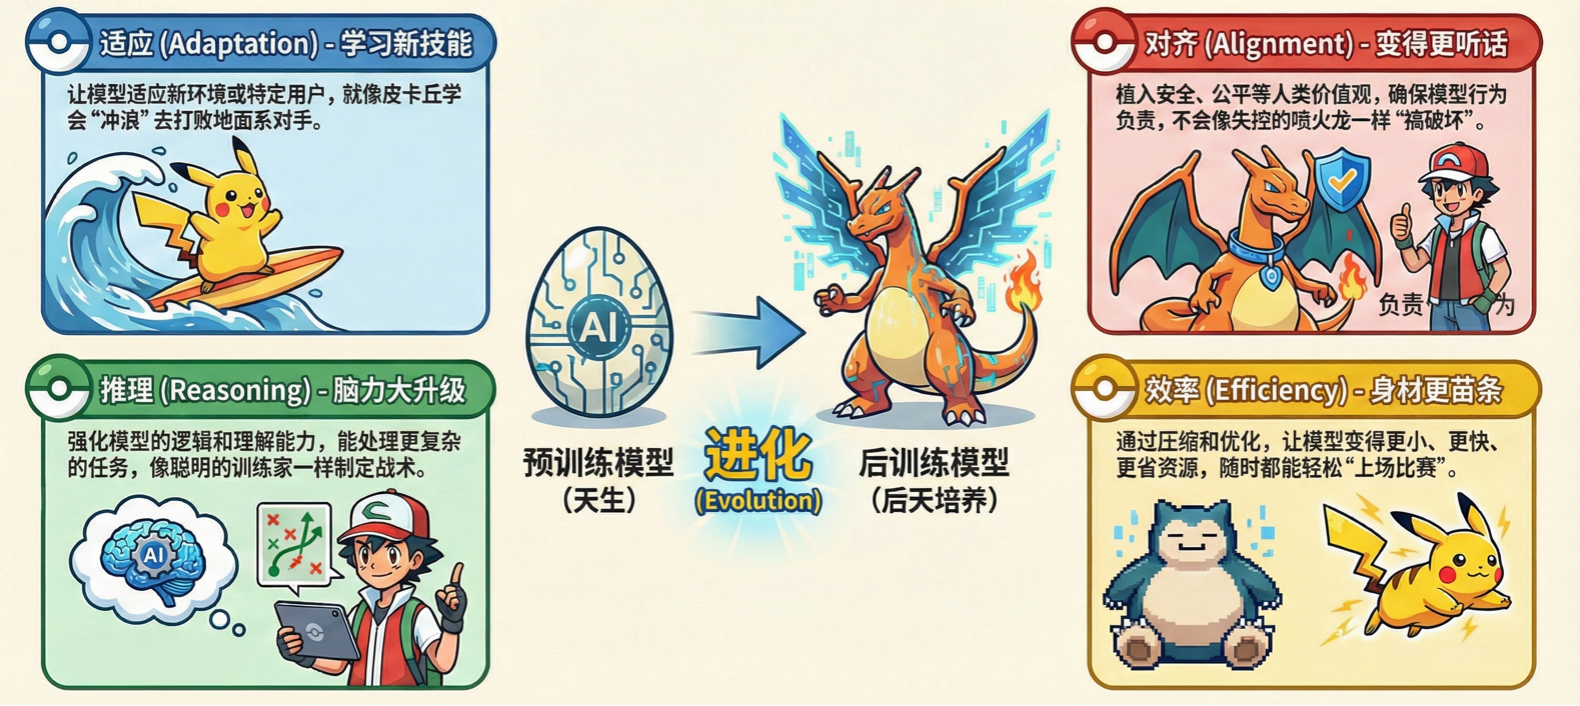
本 Special Session 将后训练视为构建自适应、负责任且具备认知能力的语音模型的关键阶段 ,主要聚焦于以下四大核心方向:
- 适配(Adaptation):让模型能够持续适应新语言、新声学环境和用户上下文,实现个性化与文化感知。
- 对齐(Alignment):将人类价值观与安全原则融入模型,确保生成内容符合伦理标准,减少偏见与有害输出。
- 推理(Reasoning):强化模型的高阶推理能力,使其能处理复杂的多轮交互、多模态推断及深层语义理解。
- 效率(Efficiency):通过模型压缩与知识蒸馏,使后训练后的模型更加轻量、可扩展且可持续
欢迎(但不限于)以下主题的投稿 :
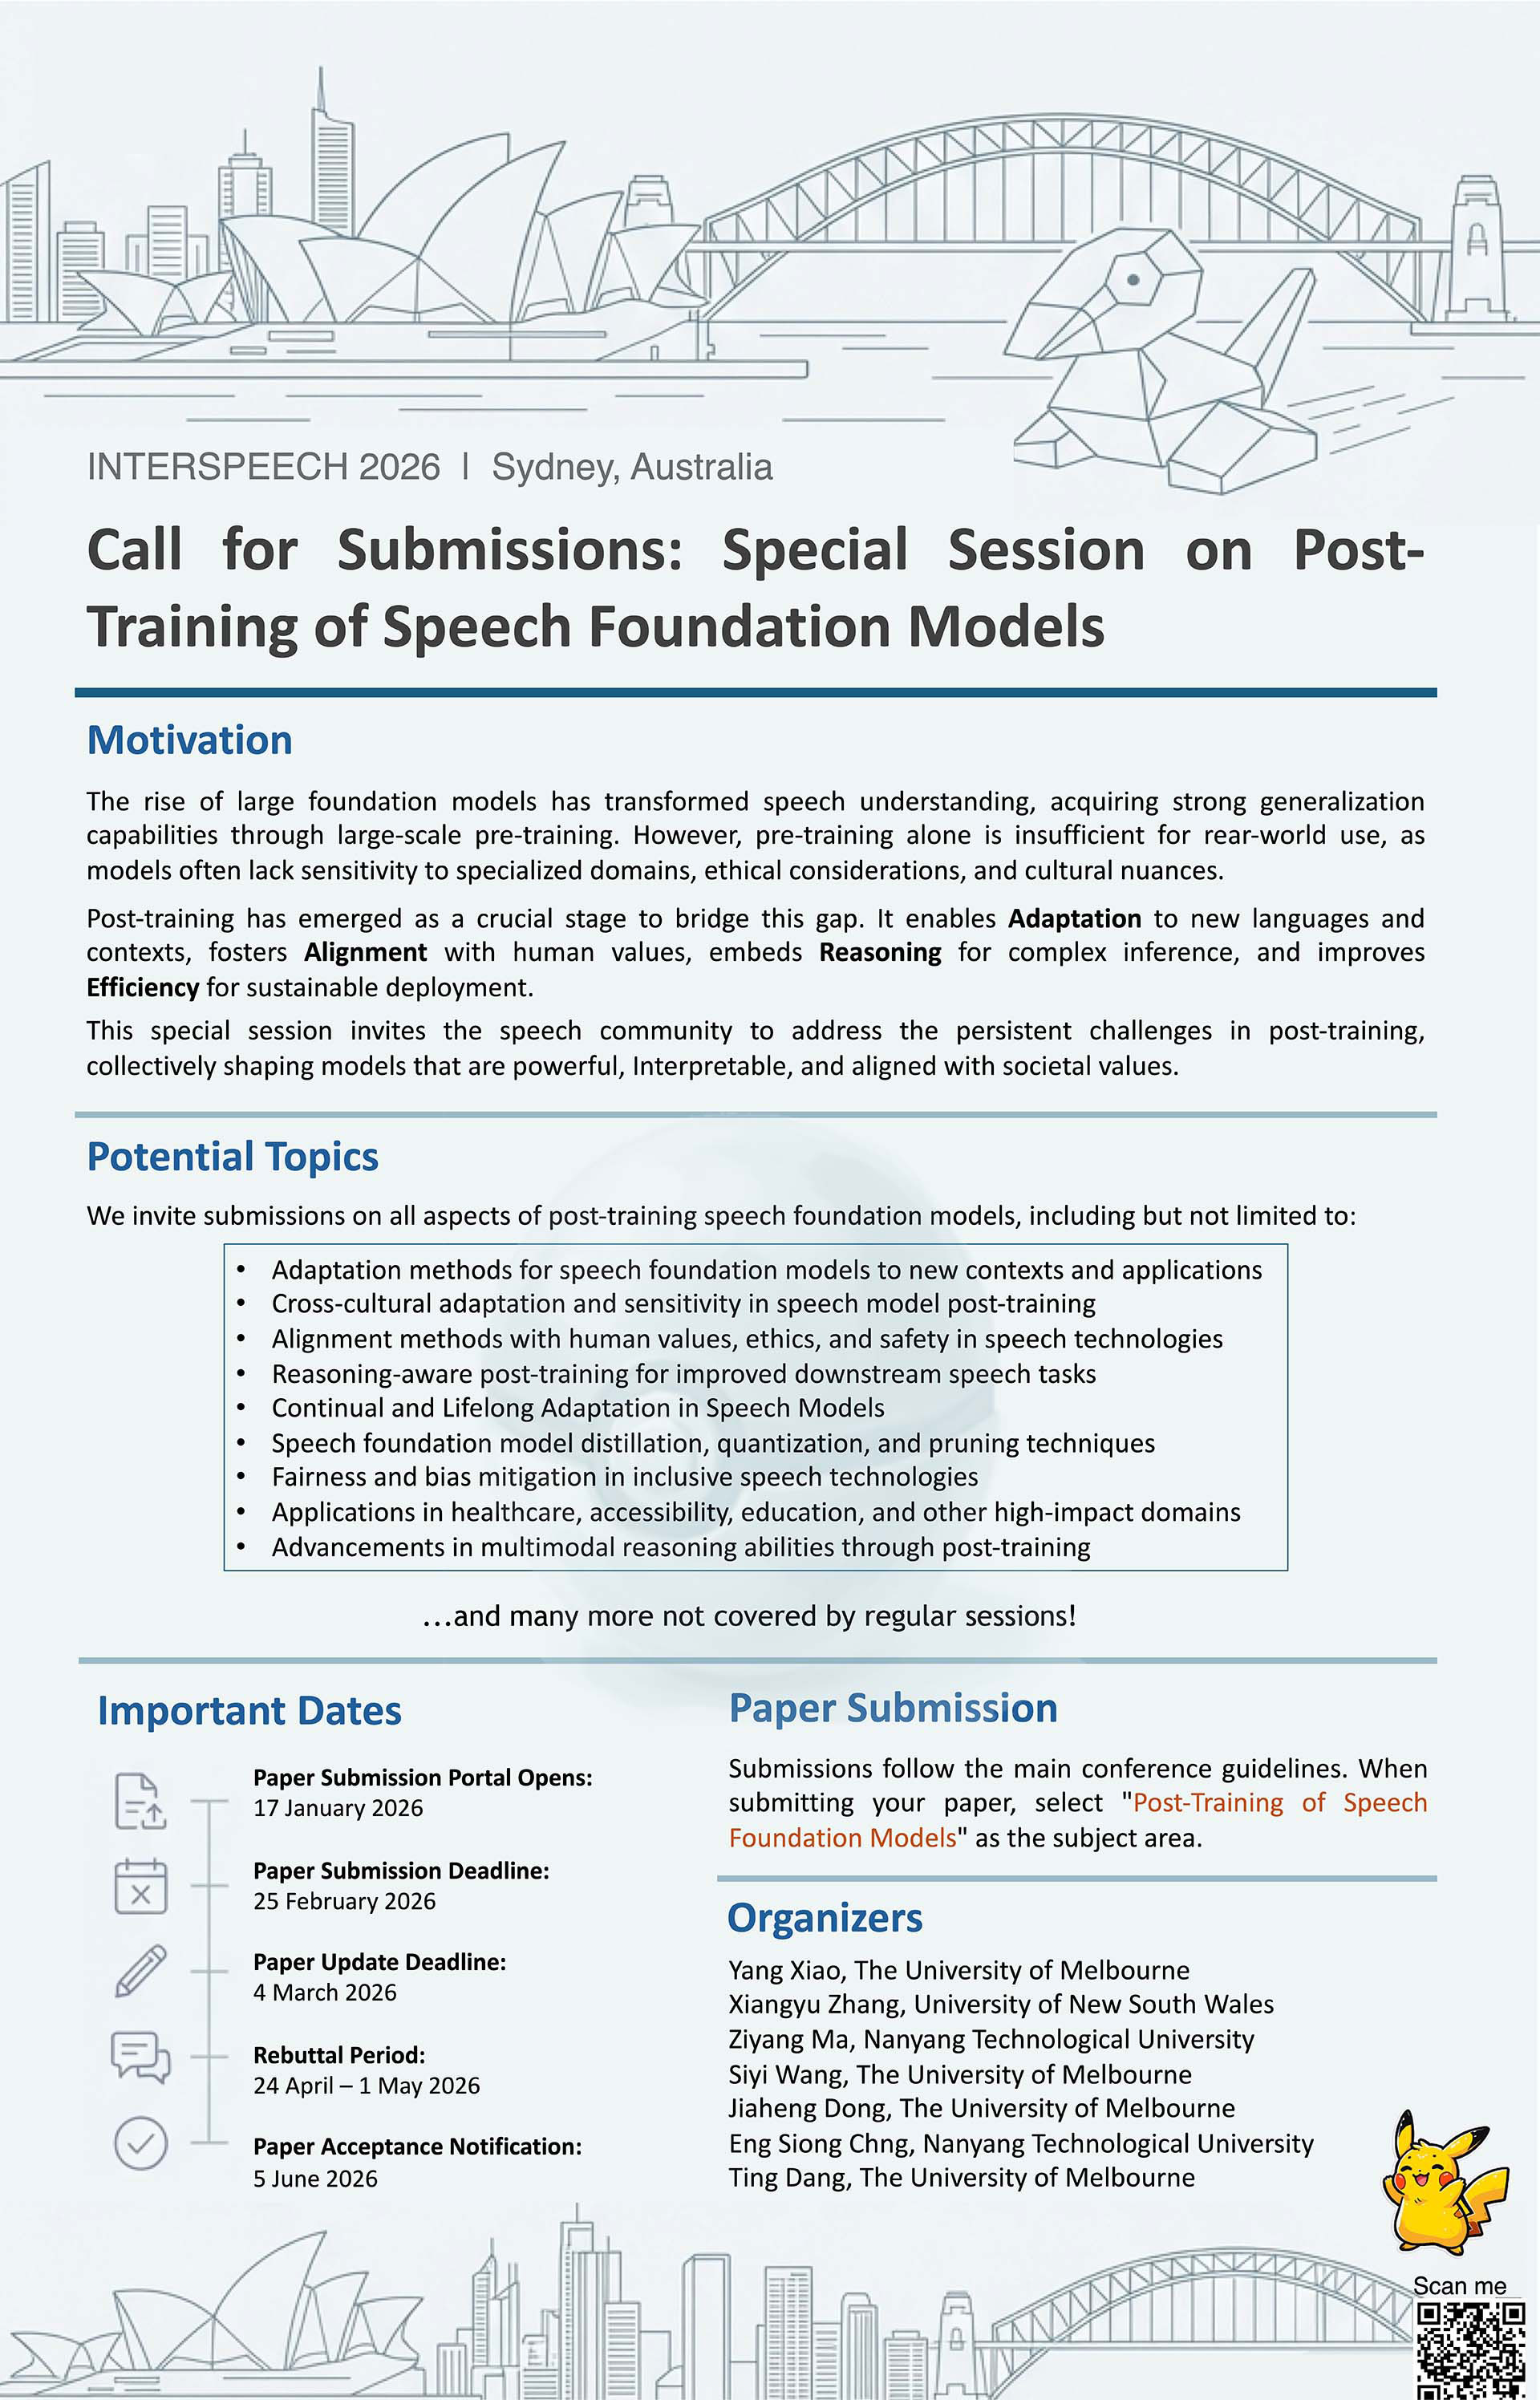
- 适配与泛化:语音基座模型面向新上下文、跨文化场景及特定应用的适配方法 。
- 数据与方法:解决后训练中数据受限问题的策略,以及高效的后训练技术(如蒸馏、量化、剪枝) 。
- 对齐与伦理:基于人类价值观、伦理与安全性的对齐方法,以及后训练中的公平性与偏见缓解 。
- 推理能力:通过后训练提升多模态推理能力,以及面向复杂声学场景的推理增强 。
- 社会应用:面向语言保护、医疗健康、无障碍辅助、教育等高影响力领域的后训练应用 。
重要日期
- Paper Submission Portal Opens: 17 January 2026
- Paper Submission Deadline: 25 February 2026
- Paper Update Deadline: 4 March 2026
- Rebuttal Period: 24 April – 1 May 2026
- Paper Acceptance Notification: 5 June 2026
组织委员会
本 Session 由墨尔本大学、新南威尔士大学、南洋理工大学等机构联合发起 :
- 肖扬(墨尔本大学)
- 张翔瑜(新南威尔士大学)
- 马子阳(上海交通大学/南洋理工大学)
- 董家亨(墨尔本大学)
- 王思懿(墨尔本大学)
- Eng Siong Chng (南洋理工大学)
- 党婷(墨尔本大学)
随着语音基座模型在高风险和多样化场景中的应用日益普及,稳健且深思熟虑的“后训练”显得愈发重要 。这不仅是技术的挑战,更是构建可信 AI 的必经之路。欢迎广大学者、工程师及行业从业者投稿,共同探讨如何塑造既强大又可信的下一代语音模型!
官方网站:https://sites.google.com/view/ptsfm
联系方式:yxiao9550@student.unimelb.edu.au