语音与音频学术速递[8.25]

今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Multi-Task Learn…
170 0 0

今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Multi-Task Learn…
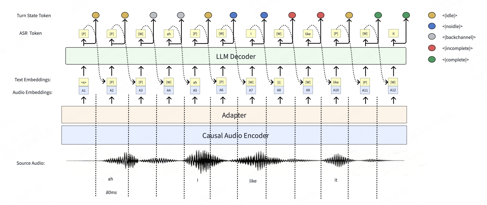
你有没有过这种体验:跟语音助手说话,刚停半秒,它就抢着回——其实你只是喘了口气; 或者你已经说完了,它还在干等,场面一度很尴尬。 这些「接话时机」问题,本质不是 ASR 认不清字,而是系统不会判断: 用户是说完了,还是话还没说完? 这句「嗯…
今日论文合集:CS.SD语音与音频 | 共 3 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Towards Quantifyi…
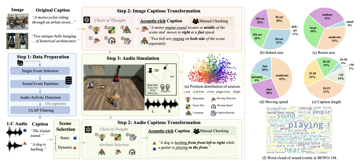
AudioCC交我学 今天,我们探讨一下如何让生成的声音准确地“落”在正确的方位。 过去两年,文本生成音频已经相当成熟,但绝大多数模型交付的仍是单通道音频——它解决了“发出什么声音”,却回避了“声音从哪里来”。而在 VR/AR、具身智能、影…
今日论文合集:CS.SD语音与音频 | 共 5 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Geometric Iterati…
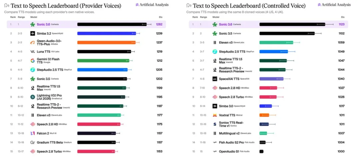
来源丨RTE开发者社区、Data接化发 Cartesia 发布 Sonic-3.6 TTS 模型,重点提升 44 种语言下的语音自然度,并称这是其目前最逼真的 TTS 版本。 相比三个月前发布的 Sonic-3.5,新版本根据开发团队反馈进…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. A Multiplication-…
小红书 FireRedTeam 开源多语言 TTS 模型 FireRedTTS3,基于语义增强的连续语音表示进行语音生成。模型包含 Base 和 Instruct 两个版本:Base 支持 24 种语言、21 种中文方言的 Zero-sho…
今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Adding Voice Clo…
近年来,大规模语音识别模型在普通话识别上取得了显著进展,但中文方言识别仍然面临数据稀缺、地域差异大、声学与词汇分布复杂等挑战。一个常见做法是在预训练 ASR 模型上继续使用方言数据进行微调,虽然能够有效提升方言识别性能,却往往会导致模型原有…
