千问发布ASR模型 Qwen-Audio-3.0-ASR-Flash,长音频不丢词,行业词不用教

今天,千问发布语音识别大模型Qwen-Audio-3.0-ASR-Flash。简单来说,就是让AI更好地听懂专业词汇。这次主要在上下文一致性、行业词识别和热词定制化三个维度做了系统性的优化,同时让模型具备语音润色能力,可直接输出结构化文本。…
30 0 0

今天,千问发布语音识别大模型Qwen-Audio-3.0-ASR-Flash。简单来说,就是让AI更好地听懂专业词汇。这次主要在上下文一致性、行业词识别和热词定制化三个维度做了系统性的优化,同时让模型具备语音润色能力,可直接输出结构化文本。…
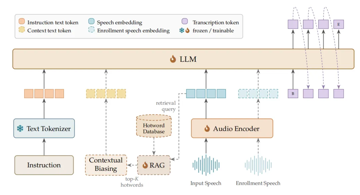
本文来源:Amphion 如果把语音识别比作一场"听力考试",传统的ASR模型就像只准备了"标准普通话朗读"这一道题的考生。而现实中的语音场景远比“听写”复杂:会议室里多人同时发言、街头嘈杂环境中的通话、医生在病房里的低声交流、客服电话中的…
从赛事启动、数据发布,到公开评测、隐藏评测与系统复核,ChinaVoices Challenge 2026 中文多方言语音识别挑战赛现已圆满完成各项赛程。经过组委会对参赛结果、系统材料与合规情况的综合核验,赛事最终结果于近日正式发布! 本届…