
声浪

Interspeech2025 | EThai-ASR:基于弱监督数据精炼和灵活序列压缩的LLM-ASR

低资源语音识别(ASR)长期面临两大核心挑战:高质量标注数据稀缺与高昂的计算需求,这在泰语等特定语言中尤为突出。现有解决方案往往受限于大规模、精确标注语料的获取难度,以及大模型(LLM)固有的计算负担。近期,西北工业大学音频语音与语言处理研…
13 0 0
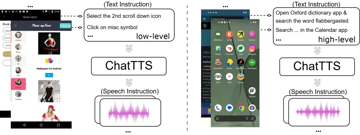
美团提出首个语音交互GUI智能体,端到端语音训练能力优于传统文本训练
GUIRoboTron-Speech团队 投稿 来源 |量子位 由美团和浙江大学联合推出的GUIRoboTron-Speech——让用户解放双手,直接对计算机“发号施令”。 联系方式:wenkangh@zju.edu.cn 论文链接:htt…
19 0 0
INTERSPEECH2025|多语种语音识别的选择性调用方法
当前全球现存超 7000 种语言,学术界和工业界对多语种语音识别(Multilingual Automatic Speech Recognition)的研究热度持续攀升,核心目标在于扩大语种覆盖范围并提升跨语言识别性能[1][2]。然而,基…
20 0 0
Interspeech2025|基于LLM与自监督训练模型的中文方言语音识别对比研究
大规模训练语料库极大地提高了语音识别(ASR)模型的性能。然而由于数据相对匮乏,口音和方言仍然是大多数ASR模型面临的挑战。自监督学习的最新进展表明,其与大型语言模型(LLM)相结合,可以有效提高低资源场景下的 ASR 性能。 近期,西工大…
21 0 0