ISCSLP 2026丨ASLP@NPU&NJU实验室8篇录用论文分享

中文口语语言处理国际学术会议(International Symposium on Chinese Spoken Language Processing, ISCSLP)是国际语音通信协会中文口语语言处理特别兴趣组(ISCA SIG-CSL…
算法资讯
20 0 0

中文口语语言处理国际学术会议(International Symposium on Chinese Spoken Language Processing, ISCSLP)是国际语音通信协会中文口语语言处理特别兴趣组(ISCA SIG-CSL…
今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音合成与声音生成 3…
中文语音交互不仅需要处理普通话,也需要面对丰富的地域方言。对于一段方言语音,系统既要判断“说的是哪种方言”,也要准确识别“说了什么”。然而,现有研究采用的方言类别、训练资源和测试集并不统一,系统性能难以直接比较。 近期,西工大音频语音与语言…
以下文章来源于音频声学实验室NJUAALab 参量阵扬声器(Parametric Array Loudspeaker,PAL)利用强超声波在空气中的非线性相互作用产生高指向性的可听声,为定向声重放与声场控制提供了新的手段。与普通扬声器不同,…
今日论文合集:CS.SD语音与音频 | 共 22 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
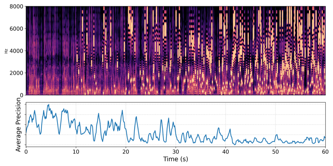
传统声纹识别只估计一个「均值」——一个确定的嵌入点,却从不估计它的「方差」——这个估计到底有多可信。而一段语音里,并不是每一帧都「平等」:噪声、混响、静音都在悄悄稀释说话人的身份线索。这个缺失的方差,正是「不确定性」。本文提出的 U³-xi…
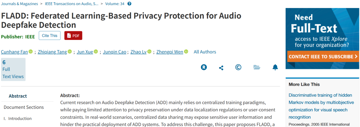
以下文章来源:生物信息感知与人机交互团队 随着语音合成与生成式人工智能技术快速发展,高质量合成语音在身份冒充、语音诈骗和虚假信息传播等场景中带来了新的安全风险,推动了音频深度伪造检测(Audio Deepfake Detection,ADD…
今日论文合集:CS.SD语音与音频 | 共 9 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测 2…
AI 做音乐这件事,过去一年我们看着 Suno、Udio 一路高歌,Demo 一个比一个惊艳,价格也一个比一个贵。 然后我们再回头看开源世界——不是模型出不来歌,就是质量差一截,或者干脆闭源让你摸不着它是怎么把词变成旋律的。 最近,港科大、…
近日,EMNLP 2026正式公布录用结果,本期分享阿里 Token Foundry Qwen Audio 团队中稿的 3 篇论文,涵盖视频到音频生成、大语言模型推理增强、神经编解码语音合成三大前沿方向。 本次入选的 3 篇论文分别围绕跨模…
