
声浪

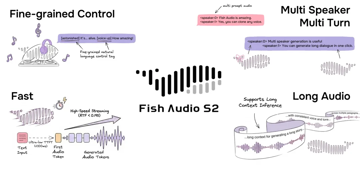
Fish Audio 开源 S2 文本转语音模型,支持1.5万种情感控制,单卡100ms极速推理!

来源丨RET开发者社区 传统的AI语音合成往往因缺乏情感表达而显得机械生硬。Fish Audio最新开源的文本转语音模型Fish Audio S2,致力于解决这一痛点。该模型能够生成包含清嗓、叹息、笑场等细微人类声学特征的语音。 模型权重、…
27 0 0
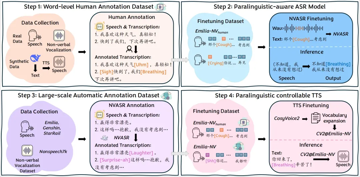
Emilia-NV:让ASR/TTS有“人味儿”的秘诀 | ICASSP2026
我们平时说话,信息不只在“字面内容”里,还藏在各种副语言声音里:笑、喘气、叹气、咳嗽,以及“嗯/啊/哦”这类带态度的语气词。它们在真实对话里承担了大量功能: 表达情绪与态度:开心的笑、无奈的叹气、不耐烦的“哼” 组织对话节奏:思考时的“呃/…
36 0 0
【语音技术和应用趋势分享系列(8)】龙虾时代的语音智能体
以下文章来源于AI语音AI思考 本系列共十篇文章,旨在深入剖析之前提到的十大趋势。 关于未来语音技术和应用趋势的10点看法 文章将穿插科普知识、技术综述、发展路线,以及我个人和其他行业专家的思考。无论读者此前对语音技术与应用了解多少,都希望…
20 0 0
创作一首新歌只需2秒!阶跃星辰开源音乐生成模型 ACE-Step 1.5
由阶跃星辰和ACE Studio联合发布的开源音乐生成模型ACE-Step 1.5,制作一首商业歌曲仅需 2-10 秒。 ACE-Step 1.5能“一人”包揽从创作端的作词、作曲、编曲,到制作端的制作人、录音师、混音师、母带师,再到前台歌…
16 0 0