百万小时无监督数据上训练80亿参数模型,多项语音任务上SoTA,语音的ImageNet时刻?(三)
前言:本文是Google于2021年9月27日发表的最新论文(10月1日更新第二版),详细介绍了Google最近一段时间在语音识别半监督领域的最新进展,包括使用一百万小时的无标签数据来训练80亿参数量的超大模型,同时还通过预训练语音识别模型…
429 1 0

前言:本文是Google于2021年9月27日发表的最新论文(10月1日更新第二版),详细介绍了Google最近一段时间在语音识别半监督领域的最新进展,包括使用一百万小时的无标签数据来训练80亿参数量的超大模型,同时还通过预训练语音识别模型…
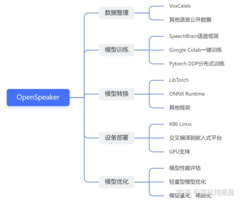
前言:有感于早些年前学习语音时,在Kaldi庞大的框架和脚本里挣扎了很久,而且对于深度学习模型训练、推理、部署、优化等也困惑了很久,现如今有时间,就想实现一套最简单的自包含方案,系统的说明一套语音服务从训练到部署的全套流程,方便新人学习,也…
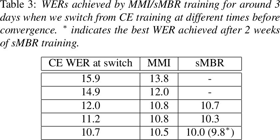
这篇文章主要调研的是一种常见的改进在线语音识别的方法:序列区分性训练(Sequence Discriminative Training)。相信有很多人已经在 CTC/CE 的训练上遇到了瓶颈,而一些新的框架如 RNN-T,End2End 的…
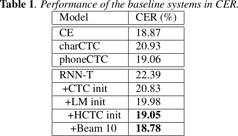
这篇文章主要调研的是另外一种改进在线语音识别的方法:基于 RNN Transducer 方法。这篇文章可能文字讲解的地方会比较少,因为图片的内容信息量已经很大了,同时论文的出处我会一并放出,有兴趣的朋友可以阅读下原文。因为我本人是基于 Te…
由CCF语音对话与听觉专委会 、中国人工智能产业发展联盟(AIIA)评估组 、腾讯会议天籁实验室、语音之家(北京)科技有限公司、北京希尔贝壳科技有限公司共同主办的【语音之家】AI产业沙龙-腾讯会议背后的语音技术,将于2021年10月12日…
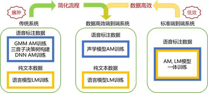
编者按:2019年底,清华大学语音处理与机器智能实验室(THU-SPMI)推出了基于CTC-CRF的ASR工具包CAT,在多个基准数据集上取得了前沿性能(State-Of-The-Art,SOTA)。近期CAT工具包有了较大改动,升级版本命…
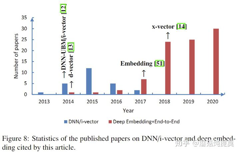
前言:做技术不能只见树木,不见森林,读综述类的论文,能很好的帮我们把握业界的前进方向。本文是由西工大张晓雷教授所作,于2021年4月4日更新,全面的分析了说话人识别方向的几个关注点,本文及接下来的几篇文章会详细的分析这篇论文。 本系列第一部…
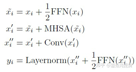
0. 前言 Conformer是Google在2020年提出的语音识别模型,基于Transformer改进而来,主要的改进点在于Transformer在提取长序列依赖的时候更有效,而卷积则擅长提取局部特征,因此将卷积应用于Transform…
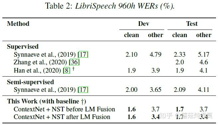
本文是Google语音团队于2020年10月发表的《Improved Noisy Student Training for Automatic Speech Recognition》,是当前半监督学习领域最新的进展之一,基于此文而来的《Pu…
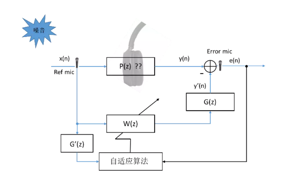
文 | S.Li 编辑 | 贰沐 子鱼 今年实在太忙,终于抽出了点空来继续更新 Active Noise Cancellation (ANC)!关于ANC耳机的基础知识已经在前面4章说的差不多了,这次主要来讲一讲实际应用中个人觉得挺重要的一…