【原理+实战】AI所有领域SOTA综述 语音识别

文章目录 前言 语音识别原理 信号处理,声学特征提取 识别字符,组成文本 声学模型 语言模型 词汇模型 语音声学特征提取:MFCC和LogFBank算法的原理 实战一:ASR语音识别模型系统的流程基于HTTP协议的API接口客户端未来 实战…
415 45 0

文章目录 前言 语音识别原理 信号处理,声学特征提取 识别字符,组成文本 声学模型 语言模型 词汇模型 语音声学特征提取:MFCC和LogFBank算法的原理 实战一:ASR语音识别模型系统的流程基于HTTP协议的API接口客户端未来 实战…
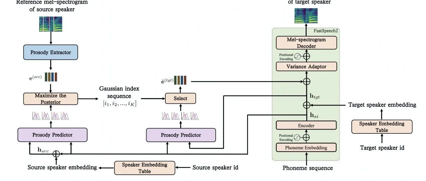
本文是上海交大2021.05.27更新的文章,该文章主要使用GMM来进行phone-level的韵律建模,从而提高语音的自然度。该文章主要在单人,多人和prosody clone三个方面进行设计和实验,具体的文章链接 https://arx…
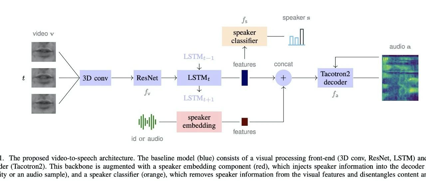
本文为University POLITEHNICA of Bucharest Bucharest, Romania在2021.05.20更新的文章,主要研究领域为video-to-speech。 具体的链接:https://arxiv.or…
李沐:”博士毕业的时候曾写过我的体会,很多同学留言说深受鼓舞。现在我想同样给大家分享这五年工作中的经验和感悟。更确切说是失败的教训,因为每一点就是付出了学费后获得的教训。希望这些同样能对大家有所帮助和启发。” 作者 | 李沐 事情的价值是对…
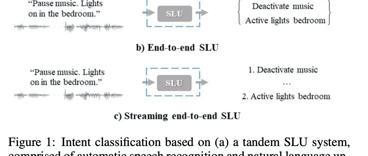
A Streaming End-to-End Framework For Spoken Language Understanding 本文为滑铁卢大学在2021.05.20更新的文章,主要做流式口语理解的工作。 具体文章链接 : https…
译者按:作者Martin Casado是软件定义网络(SDN)之父,2016年4月从从VMware离职加盟了著名的风险投资公司Andreessen Horowitz成为合伙人到现在。由于作者是工业界技术大牛,所以他的见解不随波逐流,且和笔者…
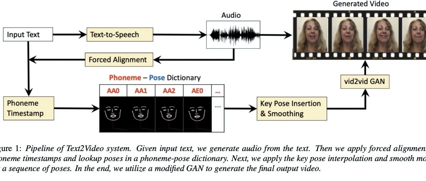
本文是Baidu Research, USA在2021.04.29更新的文章,主要工作为多模态的talking-head,把text转成video 具体的文章链接: https://arxiv.org/pdf/2104.14631.pdf…
来自谷歌的研究团队表明,将傅里叶变换取代 transformer 自监督子层,可以在 GLUE 基准测试中实现 92% 的准确率,在 GPU 上的训练时间快 7 倍,在 TPU 上的训练时间快 2 倍。 Transformer 自 2017…
腾讯 QQ,8 亿人都在使用的即时通信软件,大量用户使用它进行免费视频、音频通话。用户在进行音频通话时可能处于各种场景,嘈杂的背景声音对通话产生干扰,高质量的音频降噪能够有效提升用户通话体验。 QQ 团队基于开源 TensorFlow 机器…
对于提取伴奏,消除人声,相信从事AI语音行业的朋友对这个不会陌生,各类软件也是层出不穷,今天就跟大家分享一个高效快捷的人声伴奏分离的网站——团子 DanGo.ai。操作简单,直接在网面上传歌曲,40秒左右即可拿到背景音乐和人声。 网址:ht…