AI学子借问显卡何处有,牧童遥指我这里!(全面亲测)
AI学子借问显卡何处有,牧童遥指我这里!(全面亲测) 话不多说,开始正题,我通过视频和这篇文章的形式归纳总结了大量能让没钱的AI学生白嫖优质算力的平台,尤其是包括使用方法,改善方法,编码方法,以及实践!下面给了一个优秀的例子,能让你通过一篇…
32 0 0

AI学子借问显卡何处有,牧童遥指我这里!(全面亲测) 话不多说,开始正题,我通过视频和这篇文章的形式归纳总结了大量能让没钱的AI学生白嫖优质算力的平台,尤其是包括使用方法,改善方法,编码方法,以及实践!下面给了一个优秀的例子,能让你通过一篇…

声明:工作以来主要从事TTS工作,平时看些文章做些笔记。文章中难免存在错误的地方,还望大家海涵。平时搜集一些资料,方便查阅学习: TTS 论文列表 http://yqli.tech/page/tts_paper.html TTS 开源数据…
一、中文预处理之繁简体转换及获取拼音 在日常的中文NLP中,经常会涉及到中文的繁简体转换以及拼音的标注等问题,本文将介绍这两个方面的实现。首先是中文的繁简体转换,不需要使用额外的Python模块,至需要以下两个Python代码文件即可: •…

端到端 (End-to-end, E2E) 模型得益于其简洁的模型结构和优异的模型性能,已经成为各种序列到序列任务中的主导模型,如机器翻译 (Neural machine translation, NMT) 、语音识别 (Automatic…
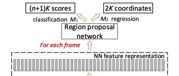
近期,实验室与出门问问AI Lab、华盛顿大学合作的论文“Region Proposal Network Based Small-Footprint Keyword Spotting“发表在IEEE Signal Processing Le…

基本理论 隐马尔可夫模型是一个双重随机过程----具有一定状态数的隐马尔可夫链和显示随机函数集。自20世纪80年代以来,HMM被应用于语音识别,取得重大成功。到了90年代,HMM还被引入计算机文字识别和移动通信核心技术“多用户的检测”。HM…
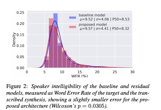
声明:语音合成论文优选系列主要分享论文,分享论文不做直接翻译,所写的内容主要是我对论文内容的概括和个人看法。如有转载,请标注来源。 Improving multi-speaker TTS prosody variance with a re…

近期,实验室王雄、姚卓远、石宪同学的论文“CASCADE RNN-TRANSDUCER: SYLLABLE BASED STREAMING ON-DEVICE MANDARIN SPEECH RECOGNITION WITH A SYLLA…

语音识别(Auto Speech Recognition, ASR)技术是一种将连续的语音信号转化为文本的技术,近年来,随着深度学习的蓬勃发展,端到端(End-to-End,E2E)语音识别技术以其简单的体系结构和优异的性能广受青睐。RNN…
日前,中国科学院自动化所(简称“自动化所”)基于全场景AI计算框架MindSpore训练完成全球首个图文音(视觉-文本-语音)三模态预训练模型(OPT-Omni-Perception pre-Trainer),该模型同时具备跨模态理解与跨模…