多模态说话人开源项目3D-Speaker

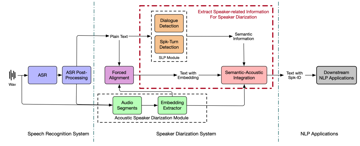
3D-Speaker是通义实验室语音团队贡献的一个结合了声学、语义、视觉三维模态信息来解决说话人任务的开源项目。本项目涵盖说话人日志,说话人识别和语种识别任务,开源了多个任务的工业级模型,训练代码和推理代码。 本项目同时还开源了相应的研究数…
154 0 0
3D-Speaker是通义实验室语音团队贡献的一个结合了声学、语义、视觉三维模态信息来解决说话人任务的开源项目。本项目涵盖说话人日志,说话人识别和语种识别任务,开源了多个任务的工业级模型,训练代码和推理代码。 本项目同时还开源了相应的研究数…

Abstract 我们介绍了一个文本到语音(TTS)模型,称为BASE TTS,它代表具有涌现能力的大自适应流TTS。 BASE TTS是迄今为止最大的TTS模型,在10万小时的公共领域语音数据上进行了训练,实现了语音自然度的新技术。 它部…


本次分享内蒙古大学S2LAB与字节跳动、港中文(深圳)合作,关于情感对话语音合成的工作《Emotion Rendering for Conversational Speech Synthesis with Heterogeneous Gra…

语音识别系统应该足够强大,能够适合所有人群——包括具有不同说话风格、口音和其他特征的人群。为了衡量自动语音识别(ASR)工具在不同人口群体中的表现,人工智能从业者需要多样化的语音数据。为了与开放科学方法保持一致,Meta发布了一个以公平为导…


今天我们介绍回声消除的优化,在前面优化回声消除过程:舒适噪声生成算法的应用与原理我们介绍了回声消除中的舒适噪声是如何产生的,这里我们介绍下线性部分的优化。我们知道在WebRTC的AEC中包含两个部分,参考

多通道语音识别(Multi-channel ASR)的目标是识别由多个麦克风(如麦克风阵列)拾取的多通道音频,相较于标准的单通道语音识别,多通道语音识别通过有效利用多通道信号提供的空间信息,帮助提升语音识别的性能。在实际应用中,由于麦克风阵…


龙年伊始,Sora横空出世,举世震惊。Sora声称“作为世界模拟的视频生成模型”,豪气干云。有人悲观预言很多传统领域可能被颠覆,其中最为岌岌可危的可能是计算机图形学,短视频和影视娱乐行业。依随OpenAI透露出更多技术细节,很多Sora生成…