SP Society Journal Paper Presentation Request

Authors of papers in the journals of the IEEE Signal Processing Society will have the opportunity to present their work…
87 0 0

Authors of papers in the journals of the IEEE Signal Processing Society will have the opportunity to present their work…
近期,新加坡国立大学Human Language Technology (HLT) 实验室提出神经网络自动配音模型VisualTTS: TTS with Accurate Lip-Speech Synchronization for Aut…
快手是一个短视频社区,短视频和直播中通常混合各种形式的声音,如语音、音乐、特效音和背景噪声等,这些声音很好的提升了短视频和直播的用户消费体验,但同时也为音频内容理解带来极大的困难和挑战。如何在复杂场景下准确高效的进行说话人识别,通常需要引入…
Abstract Over the last several years, there has been growing interests in developing end-to-end (E2E) automatic speech r…
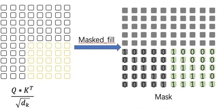
大家好,好久不见,今天想给大家分享一些关于Mask的一些理解和小技巧。 来源丨433的3号同学 作者丨贾彦 如果你要对transformer进行改动,就必然要去重新构建你的mask,那么本文会对transformer中的mask机制进行详细…
Targeting at the topics on industry and application trends of emerging signal processing technologies, the ICASSP 2022 o…
导读:今天分享的主题是实时语音对话场景下的智能对话的一些实践。其中实时语音场景特指通过电话来进行一个语音对话。 主要内容包括3个部分: 语音对话的机器人:热线小蜜 语音特色的文本驱动对话 语音语义驱动的双工对话 01语音对话机器人:热线小蜜…
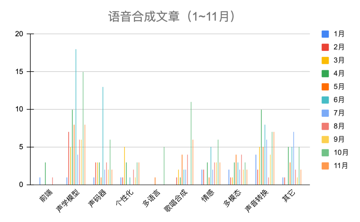
论文统计每月更新一次,主要跟踪语音合成和语音识别的发展状况(很多文章都是在会议后才发出,但不影响统计。统计过程难免存在疏漏,因此统计结果仅供参考。 所有文章语音合成领域统计列表请访问:http://yqli.tech/page/tts_pa…
语音和多模态人机交互会是以机器人为代表的智能硬件的必备特征, 实践中首先要克服的是声学环境的复杂性。在声学前端核心技术上, 深挖信号处理的在线自适应能力, 以及经典信号处理与任务模型的联合优化是我们的技术特色, 也因此在高噪声、高性价比等实…
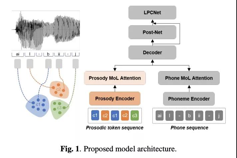
声明:平时看些文章做些笔记分享出来,文章中难免存在错误的地方,还望大家海涵。 搜集一些资料,方便查阅学习:http://yqli.tech/page/speech.html 语音合成领域论文列表请访问:http://yqli.tech/pa…