NCMMSC 2021 “语音关键词识别”双赛道冠军方案分享—网易易盾
第十六届全国人机语音通讯学术会议(NCMMSC 2021)公布“长短视频多语种多模态识别挑战赛”(Video Keyword Wakeup Competition)-— 汉语长短视频直播语音关键词(VKW)任务最终成绩。 历时4个月的征集与…
288 0 0

第十六届全国人机语音通讯学术会议(NCMMSC 2021)公布“长短视频多语种多模态识别挑战赛”(Video Keyword Wakeup Competition)-— 汉语长短视频直播语音关键词(VKW)任务最终成绩。 历时4个月的征集与…

伴随着视频技术的进步和标准的迭代,视频产业从模拟进入到数字时代,完成了从电影电视到互联网的媒介转换,并且衍生出了超高清、3D、AR/VR 等多种创新形态。特别是在后疫情的当下,我们可以看到音视频技术领域的诸多新变化,云与端的协同互动、算法创…
前沿 本文大家一个完整的中文语音识别系统,包括声学模型和语言模型,能够将输入的音频信号识别为汉子 该系统实现了基于深度框架的语音识别中的声学模型和语言模型建模,其中声学模型包括CNN-CTC、GRU-CTC、CNN-RNN-CTC,语言模型…
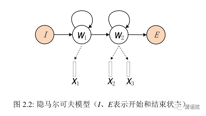
语音识别的全程是自动语音识别(Automatic Speech Recognition,ASR),说得多了,就把“自动”省去了,认为“自动”是理所当然的了。语音识别属于序列转换技术,它将语音序列转换为文本序列。大体来说,这是一次搬运,是吧一…
在过去的一年中,我们可以看到多媒体特别是音视频技术的能力在严峻的挑战下,为各行各业带来了巨大的变化。疫情过后,又会有哪些多媒体新技术、新实践呈现在大众的视野当中?为行业的发展与应用带来哪些新的趋势与机会? 10 月 29 日 - 30 日,…
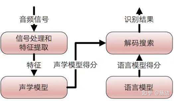
1、概述 声音从本质是一种波,这种波可以作为一种信号来处理,所以语音识别的输入实际上就是一段随时简播放的信号序列而输出则是一段文本序列。将语音片段输入转化为文本输出的过程就是语音识别。 一个完成的语音识别系统通常包括信号处理和特征提取、声学…
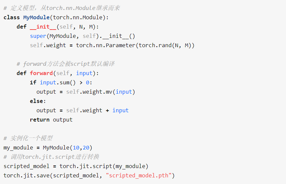
今天我们先看一下通用的模型部署场景,然后讨论一下Libtorch模型转换。 深度学习模型部署 深度学习模型训练完成后,需要将模型部署应用,该部门一般无需再考虑如何修改训练方式或者修改网络结构以提高模型精度,更多的是需要明确部署的场景、部署方…
根据规划,今天来看第二部分模型训练: 1、声纹模型 声纹识别已有几十年的历史,但是真正的声纹模型应用,应该是从深度学习兴起之后,目前主流的声纹识别系统,也基本都是基于深度学习的方法来做的,包括经典的d-vector, x-vector, R…
首先语音识别系统对收集到的目标语音进行预处理,这个过程就已经十分复杂,包含语音信号采样、反混叠带通滤波、去除个体发音差异和设备、环境引起的噪声影响等等。之后对处理的语音进行特征提取。 语音识别的原理其实并不难理解,原理上和指纹识别的原理相同…