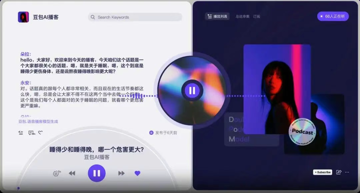
字节发布AI豆包 · 语音播客模型!

昨天,火山引擎旗下豆包团队推出的豆包·语音播客模型,以三大核心技术突破重塑播客内容生产逻辑。这一模型基于流式技术实现文本到双人对话式播客的即时转换,生成的自然语音在流畅度、情感表现和语义连贯性上均达到专业录制水准,甚至能通过深度搜索功能在5…
42 0 0
昨天,火山引擎旗下豆包团队推出的豆包·语音播客模型,以三大核心技术突破重塑播客内容生产逻辑。这一模型基于流式技术实现文本到双人对话式播客的即时转换,生成的自然语音在流畅度、情感表现和语义连贯性上均达到专业录制水准,甚至能通过深度搜索功能在5…

在复杂环境中保持清晰语音感知一直是助听设备与消费级耳机的核心挑战。传统主动降噪(ANC)技术虽能抑制环境噪声,但会无差别削弱所有声音,导致用户难以听清目标方向的语音(如对话者)。近年来,开放式耳机因佩戴舒适、减少耳道堵塞效应等优势备受关注,…


2025年IEEE国际声学语音与信号处理会议(International Conference on Acoustics, Speech, and Signal Processing,ICASSP 2025)苏州卫星会议即将于5月23日-2…

来源丨新智元 AI能写论文、画图、考高分,但连「看表读时间」「今天是星期几」都错得离谱?最新研究揭示了背后惊人的认知缺陷,提醒我们:AI很强大,但精确推理还离不开人类。 有些任务对人类来说轻而易举,但AI频频出错。比如,单词「strawbe…

当置身于一场音乐会,闭上眼睛,我们仍能凭借声音判断乐器的位置;在电影院,环绕音效让我们仿佛置身于电影场景之中。空间音频,作为一种能够模拟真实听觉环境的技术,正逐渐成为提升沉浸式体验的关键。然而,现有的技术大多基于固定的视角视频,缺乏对 36…


最近,TTS 模型又有重磅“上新”,Speech-02语音模型一出手,就将 OpenAI、ElevenLabs 甩在了后面,登顶 Arena 榜单,成为全球第一。 性能更强之外,Speech-02 还极具性价比,成本仅为 ElevenLab…
