
技术解读|Qwen Audio Agent 系列:座舱语音助手新范式

一边聊天,一边办事。 从办公协作,走进智能座舱。 在上一篇《qwen-audio-agent架构解析》中,我们主要围绕办公场景介绍了框架。这一次,我们把它带进智能汽车座舱。 我们做了一套可运行的智能座舱示例:接入车控、音乐、导航与天气,让用…
资讯算法
94 0 0

一边聊天,一边办事。 从办公协作,走进智能座舱。 在上一篇《qwen-audio-agent架构解析》中,我们主要围绕办公场景介绍了框架。这一次,我们把它带进智能汽车座舱。 我们做了一套可运行的智能座舱示例:接入车控、音乐、导航与天气,让用…

来源丨新智元 谷歌又杀回来了。 今夜,Google DeepMind 一口气放出两个模型——Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking。 官方称它们是谷歌迄今最先进的实时对话模型。…

今天,阶跃正式发布 Step Audio 3 系列模型,包括 StepAudio 3 Realtime、StepAudio 3 ASR、StepAudio 3 TTS、StepAudio 3 Gen 和 StepAudio 3 Music。…

今日论文合集:CS.SD语音与音频 | 共 9 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音合成与声音生成 2…

分享天津大学认知计算与应用重点实验室9篇论文被INTERSPEECH 2026 录用的论文。本次录用工作覆盖大音频语言模型、音频推理智能体、阿尔茨海默病语音检测、鲁棒说话人验证、上下文表现力语音评估以及自监督语音表征学习等方向。 ⏩1. M…

今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
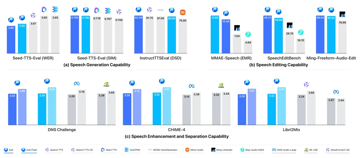
语音克隆、指令驱动语音合成、语音编辑、语音增强、语音分离...如果你最近关注过语音模型,这些能力大概率分散在多个不同的模型里。 而腾讯混元最新开源的 AuK,把生成和编辑这一整条能力链,塞进了一个统一框架,并通过少步蒸馏得到了推理加速版本…

随着AI音频处理工具不断向在线化发展,一些原本需要借助专业音频软件完成的任务,如人声分离、伴奏制作和音乐分轨,如今已经可以直接通过浏览器完成。Tunii近期推出了一系列基于浏览器的AI音频工具,面向人声分离、伴奏制作、音乐分轨以及视频音频处…
今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…

语音交互和语音通信依赖清晰、可分辨的输入信号。真实环境中的风扇、道路、键盘等背景噪声会掩盖语音,扬声器回放进入麦克风会形成回声,多人同时讲话则会造成语音混叠。降噪、声学回声消除(AEC)和语音分离分别处理这三类问题,直接影响语音识别、唤醒与…
