
 语音小管家
One-shot Voice Conversion(单样本语音转换)这件事,直观理解就是:
给模型一段“你说的话”,再给它一小段“目标说话人”的参考音,模型输出的语音内容不变,但音色变成目标说话人。
这类技术在论文demo里通常效果很好。但一到真实场景,问题就来了:
用户上传的参考音,很多是从互联网视频/播客/采访里截的
里面常带着环境噪声、底噪、混响、风声、背景音乐
模型一旦把这些噪声也当成“说话人特征”,转换结果就容易翻车
具体会怎么翻?
常见现象包括:
目标音色学不稳,像不像都不太对
内容可懂度下降,字词更容易糊掉
在特别吵的场景里(比如 SNR < 5 dB),性能掉得更明显
现有方法为什么还不够?
已有工作大致有两条路:
前面先接一个语音增强模块
先降噪,再做VC
问题是:不是端到端,推理时更慢、更重
训练时做噪声增强/鲁棒训练
有帮助,但在极端噪声下仍然不够稳
所以,我们想解决的是一个非常现实的问题:
如果目标说话人的参考音本来就很吵,模型还能不能只学“谁在说”,别把“环境有多吵”也一起学进去?
「解决方案」
我们提出了一个专门面向带噪参考音的一键变声系统:NORO。
它的核心思想其实很清晰:
把“说话人音色”从“噪声环境”里剥离出来。
论文的做法可以拆成三步来看。
✅核心工作一:先把VC任务拆开——内容、音高、音色分别建模
NORO建立在一个 diffusion-based one-shot VC 基线系统上。这个基线大致分三部分:
1)源语音分支:提取“你说了什么”
从源语音里提取:
语义信息:用 HuBERT 表示“内容”
音高信息:用 F0 表示“怎么说”
这样模型知道:
文字内容是什么
语调起伏是什么
2)参考语音分支:提取“谁在说”
从目标说话人的参考音里提取:
音色/说话人特征
3)扩散声学模型:把三者拼起来生成结果
最终让模型学会:
保留源语音的内容和音高
换成目标说话人的音色
问题就出在这里
如果参考分支提取出来的不只是“说话人音色”,还混进了“风声、底噪、环境声”,那后面整个转换都会被带偏。
所以,NORO的重点不是重做全部模型,而是:
把参考音分支变得“抗噪”。
✅核心工作二:双分支参考编码器——同一个人,干净版和带噪版一起学
这是NORO最关键的设计。
我们把原本单一路径的参考编码器,改成了一个双分支参考编码模块:
一条分支输入:干净参考音
另一条分支输入:人为加噪后的同一段参考音
两条分支共享同一套参数
也就是说,训练时模型会同时看到:
同一个说话人在“干净环境下怎么说”和“带噪环境下怎么说”
带噪音频怎么造?
我们用 DEMAND 噪声库里的 8 种噪声,把干净参考音随机混合成带噪版本。SNR 范围也做得比较真实,覆盖从轻噪到重噪的情况。
这样做的直觉是什么?
很像在告诉模型:
“这个人是谁”是稳定的
“环境噪声是什么”是不稳定、应该忽略的
一个很实用的点
虽然训练时是双分支,推理时只用一个参考编码器。
也就是说,NORO不像“先增强再变声”那种方案会增加推理链路;它在部署时的结构,和普通VC系统差不多,不会额外变得更重。
✅核心工作三:噪声无关对比损失——强迫模型记住“人”,忘掉“噪声”
如果说双分支是“喂数据的方法”,那这个损失函数就是“教模型怎么学”。
我们设计了一个noise-agnostic contrastive speaker loss(噪声无关对比说话人损失)。
它的目标很直接:
同一个说话人:
干净参考音的表示
带噪参考音的表示
要尽量靠近
不同说话人:
它们的表示要尽量拉远
换句话说,这个损失在逼模型学会:
同一个人,换个噪声环境,还是同一个人。不同的人,哪怕环境差不多,也不能混。
这一步非常关键,因为它真正把“说话人特征”和“环境噪声”在表示空间里拆开了。
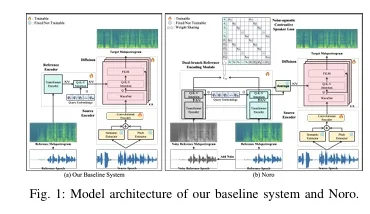
图1|NORO整体框架:在原始 one-shot VC 基线之上,引入双分支参考编码与噪声无关对比学习,让模型从带噪参考音中更稳定地抽取说话人音色。
「关键结果:一旦参考音变吵,基线就掉;NORO扛住了」
我们分别在干净和带噪两种场景下测试。
干净测试集:VCTK
带噪测试:给参考音加入训练时没见过的噪声,并分不同SNR评估
评测指标包括:
CER:字错率,越低越好
SECS:与目标说话人相似度,越高越好
主观听感:自然度、相似度评分
✅结果一:干净环境下,NORO几乎不掉点
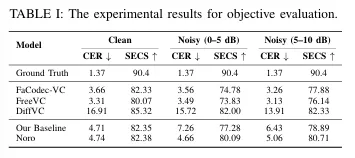
在干净参考音条件下:
Baseline:CER 4.71,SECS 82.35
NORO:CER 4.74,SECS 82.38
这说明什么?
NORO并不是靠“牺牲正常场景”来换鲁棒性。在干净环境里,它和原系统几乎打平。
这点很重要,因为很多“增强鲁棒性”的方法会顺带伤害干净场景表现,而NORO基本没有明显副作用。
✅ 结果二:重噪场景下,NORO提升非常明显
在最难的 0–5 dB 噪声条件下:
Baseline:CER 7.26,SECS 77.28
NORO:CER 4.66,SECS 80.09
也就是说:
内容可懂度明显提升
说话人相似度也更稳
在 5–10 dB 条件下,NORO同样优于基线:
Baseline:CER 6.43,SECS 78.89
NORO:CER 5.06,SECS 80.71
一句话总结:
参考音一带噪,基线明显崩;NORO还能维持住。
✅ 结果三:主观听感也验证了这点
主观测试结果更能说明真实使用体验。
干净场景
Baseline:自然度 3.29,相似度 3.02
NORO:自然度 3.16,相似度 2.90
差距不大,说明正常情况下两者都能用。
重噪场景(0–5 dB)
Baseline:自然度 2.09,相似度 2.75
NORO:自然度 2.95,相似度 2.97
这就很明显了:
在最接近真实互联网参考音的条件下,NORO听起来更自然,也更像目标说话人。
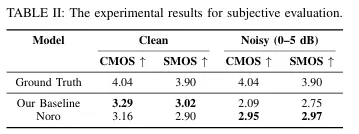
干净场景下两者差异不大,但在重噪参考音下,NORO的自然度和相似度都明显优于基线。
✅ 结果四:为什么NORO有效?看表示空间就知道了
我们还做了一个很直观的 t-SNE 可视化。
Baseline 的情况
干净参考音和带噪参考音的表示,明显分成两团。这说明模型把“是否带噪”也编码进了参考表示里。
NORO 的情况
干净和带噪参考音的表示混在一起。这说明模型学到的是:
主要按说话人组织
而不是按噪声环境组织
这正是“noise-agnostic speaker representation(噪声无关的说话人表示)”想达到的效果。
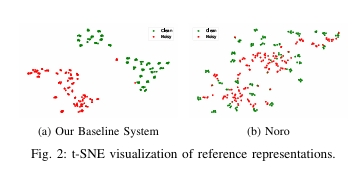
图2|Baseline 的参考表示会被‘是否有噪声’分开;NORO 则把干净和带噪参考音映射到更接近的区域,说明模型更关注‘谁在说’,而不是‘环境有多吵’。
「额外发现:VC模型里,居然藏着一个说话人表示模型」
这篇论文还有一个很有意思的副产品。
我们发现:one-shot VC 里的参考编码器,本质上一直在做一件事:
从一段语音里抽取“这个人是谁”的信息
那它能不能直接拿来当speaker encoder(说话人编码器)用?
我们把这个参考编码器单独拿出来,命名为VC-SPK2VEC,并在 SUPERB 的 speaker verification 任务上测试。
结果怎么样?
它拿到了5.32% EER,表现相当有竞争力:
优于 wav2vec 2.0 Large:5.65
优于 HuBERT Large:5.98
接近 HuBERT Base:5.11
当然还略落后于最强的 WavLM 系列
但重点在于:
这个模型原本不是专门为“说话人验证”设计的,它只是一个做 one-shot VC 的参考编码器。
这说明 one-shot VC 任务本身,就在逼模型学习很强的说话人表示能力。
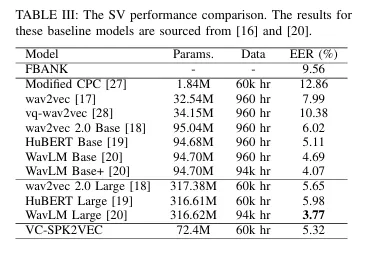
把VC里的参考编码器拿出来做说话人表示,能在SUPERB设定下拿到5.32%的EER,表现接近主流SSL模型。
「这件事为什么值得关注?」
这篇论文的目的,其实不只是为了让“抗噪VC又提升了一点”。
它更重要的意义在于两点:
1)让 one-shot VC 更接近真实应用
现实里用户给你的参考音:
不会都来自录音棚
很多就是手机录音、播客片段、视频截音
如果模型只能吃“干净样本”,那产品就很难落地。NORO正是在补这一块短板。
2)把“生成任务”和“表示学习任务”连起来了
论文额外证明了一点:
做 voice conversion 学出来的参考编码器,其实也能反过来做 speaker representation。
这给后续研究提供了一个很有意思的方向:
一边做语音生成/变声
一边顺手学说话人表示
未来也许能把 speaker embedding 和生成式语音任务更深地统一起来
「总 结」
这篇论文可以浓缩成三句话:
1)问题很现实
真实世界里,参考音经常是带噪的,而普通 one-shot VC 在这种场景下很容易掉性能。
2)方法很克制
NORO没有靠“外挂增强模块”硬堆系统,而是直接在参考分支里学噪声无关的说话人表示:
双分支参考编码器
噪声无关对比损失
3)结果很实用
干净场景基本不掉
带噪场景显著更稳
参考编码器还有潜力直接变成speaker encoder
如果一句话总结这篇工作,那就是:
NORO做对的一件事,是让模型在嘈杂参考音里,仍然优先记住“谁在说”,而不是“环境有多吵”。
