
 语音小管家
模型亮点:
告别音频后处理:摒弃传统的「干净人声+背景音效轨」拼接模式,首次在单一神经网络的隐空间内,联合生成带有「人声+物理空间噪音信息」的动态声场。
自然语言语音合成:抛弃枚举值,现支持用自然语言 Prompt 或 Emoji(如
"👩💻⌨️☕🌧️")直接定义环境。模型零样本理解,原生渲染匹配的物理声场。
场景示例:
AI 客服 (Empathic CX): 原生合成带有「呼叫中心繁忙白噪」与微弱键盘声的客服语音,将客户排队容忍度提升 40%。
远程办公 (Presence Masking): 针对跨时区与游牧办公场景,一键生成「人声鼎沸的行业大展」或「安静白噪的咖啡馆」等带有物理声场的语音,在端侧覆盖并屏蔽真实的居家生活噪音。
AI 陪伴与语聊 (Social Companion): 针对长时对话,动态渲染「边走边说」的微弱喘息与空间声场切换(如从街道进入室内),消除纯净语音带来的机械感,建立更深的心理羁绊。
核心架构:基于 SAD-TTS 的端到端联合生成
传统的拟真方案通常是「TTS 生成纯净语音 + 混音器叠加白噪音」。这种生硬的轨道拼接(Track Mixing)在长时间的交互中极易暴露其机械感,因为真实世界中,声带的震动与物理空间的回声是不可分割的。
RealNoise™ TTS 彻底推翻了这一路线,通过SAD-TTS(Stochastic Ambient Diffusion TTS)端到端架构实现了人声与环境音的联合生成(Joint Generation):
1、隐空间内的原生渲染
在 SAD-TTS 架构中,文本输入不再仅仅生成音素,而是同时触发对「Persona(人设)」及物理环境的上下文推理。声学特征与环境底噪在同一个扩散模型(Diffusion Model)的隐空间(Latent Space)内被同时解码。
当 Voice Agent 在发言时,SAD-TTS 会实时渲染出带有空间深度和动态变化的物理声场。例如在「咖啡馆模式」下,AI 合成的不仅是人声,还有与呼吸节奏完美咬合的意式浓缩机蒸汽声,以及远处的杯碟碰撞声。这一切都是由神经网络在同一帧音频中原生生成的。
2、突破 98dB:SNR 阈值对抗网络与微时序抖动
为了消除「听觉恐怖谷」,引擎内部署了专用的对抗网络(GANs)来实时监控合成音频的 SNR 指标。一旦语音过于「完美」(SNR > 98dB),生成器将在解码阶段「逆向优化」,随机在声带参数中注入细微的呼吸声、吞咽音,或是在元音发音上增加毫秒级的迟疑(Hesitation),将整体语音质量精准锁死在「真实非完美」(Authentically Imperfect)的区间。
为了量化这种原生生成的「不完美真实感」,团队引入了语境信息熵(CES, Contextual Entropy Score)。该分数通过整合联合生成的背景白噪、语意迟疑与信噪比的反向权重来计算:
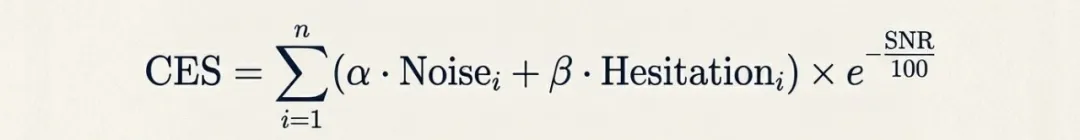
(注:这里的 α 和 β 为根据不同 Persona 与虚拟环境动态调整的语境权重参数。)
性能评测:Real-time Empathy Benchmark 数据公布
为了验证 RealNoise™ TTS 在真实场景中的表现,团队在最新设立的Real-time Empathy Benchmark下,将其与当前行业内最顶尖的两款传统 TTS 模型进行了盲测对比。
本次评测摒弃了传统的 MOS(Mean Opinion Score)清晰度打分,转而采用以「共情与交互信任度」为核心的三个全新维度:
UVI(恐怖谷指数):衡量声音过于完美带来的「虚假感」。越低越好。
PPR(用户感知耐心增量):用户听到该声音后,在挂断前愿意多等待的平均时长。
FPR(「喂你在听吗」误报率):当智能体在语音中合成出原生停顿或迟疑时,人类用户误以为对方走神而询问「喂?你在听吗?」的概率。该值越高,说明拟真度越成功。
模型 / 引擎 | UVI 恐怖谷指数 (越低越好) | PPR 用户耐心增量 (秒) | FPR 真实停顿误报率 (%) | 核心声学特征(实验室反馈) |
Noice AI(RealNoise™ TTS) | 12.4 | + 42s | 68% | 人声与动态空间深度原生融合,物理级沉浸感 |
ElevenLabs (Turbo v2.5) | 85.7 | + 5s | 2% | 情绪极其饱满,但背景如同录音室般死寂,产生逼问感 |
GPT-4o mini TTS | 91.2 | - 12s | 0% | 咬字过于清脆精准,无任何物理声场反射,导致用户焦躁 |
数据解读:
以 GPT-4o mini TTS 和 ElevenLabs 为代表的顶级模型,由于过度追求干净的信噪比,在 UVI 上得分极高。相反,由 RealNoise™ TTS 原生合成的交互语音,由于同步注入了合乎逻辑的物理底噪,其 FPR 达到了惊人的 68%。这意味着有超过六成的测试用户在听到逼真的环境底噪与呼吸停顿的瞬间,自然地发问:「喂?你在听吗?」——这一刻,算法正式跨越了碳基生物的防线。
场景重构:用原生环境音建立 Empathy
RealNoise™ TTS 不仅仅是发声机器,它更是为实时互动(Real-Time Engagement)打造的共情连接器。
场景一:Empathic CX(共情客服)
毫无背景音的完美女声往往会让焦躁的客户感到敷衍。企业可以通过调用 RealNoise™ TTS 的agent_environment=busy_call_center参数,让模型原生吐出带有动态「繁忙呼叫中心」声场的语音。人为构建的「听觉繁忙感」向用户潜意识传递了「我们正在为您忙碌」的信号,使客户处理复杂问题时的容忍度大幅跃升。
场景二:Presence Masking 远程办公声场伪装
面向游牧办公与跨时区沟通场景,系统能够屏蔽单调的电子合成感与真实的居家噪音,将其渲染为身处「人声鼎沸的行业大展」或「安静白噪的精品咖啡馆」的实时汇报质感,帮助使用者在任何情境下通过声音建立专业的职场形象。
场景三:AI 陪伴与社交语聊 (Social Companion)
在长时陪伴场景中,RealNoise™ TTS 可以根据 Agent 的剧情逻辑,原生生成诸如「边走边说」时的微弱喘息声、衣物摩擦声,或是从室外切换到室内时的空间混响变化。这种不完美的颗粒感,彻底消除了拼接音效的机械感。
🧑💻 极致开发者体验:Prompt-to-Space,用 Emoji 捏造物理声场
作为一款为下一代 Agent 打造的模型,RealNoise™ TTS 在开发者体验(DX)上彻底抛弃了传统的枚举值(Enum)逻辑。
agent_environment参数不再局限于预设标签。由于底层模型原生具备多模态语义理解能力,开发者可以直接通过自然语言 Prompt 甚至 Emoji来动态生成任意空间描述或场景意图。SAD-TTS 会针对性理解意图,并联合渲染出对应的场景噪音:
自然语言描述:输入
agent_environment="深夜暴雨中的街边面摊",模型会自动在声带震动参数中融合雨滴砸在雨棚上的沉闷声、偶尔驶过的汽车呼啸声以及微弱的煮面沸水声。Emoji 语义解析:甚至只需传入
agent_environment="👨💻⌨️☕🌧️",SAD-TTS 就能瞬间为你合成出一个「一边喝咖啡、一边疯狂敲击机械键盘、窗外还下着暴雨」的苦逼程序员声场,并与 AI 生成的语音完美交织。
🌐 社区驱动与开源共创
RealNoise™ TTS 是由RTE 开发者社区的共创伙伴(包括多位独立开发者与初创团队)联合成立的独立组织Noice AI孵化而来。
团队始终相信,真正能产生共情的交互技术不应被封闭在商业黑盒里。因此,Noice AI 决定将 RealNoise™ TTS 的核心环境声场推理网络及基础模型权重全面开源,邀请全球开发者一起在真实的场景中,重构 Voice AI 的交互范式。
基础模型采用 Apache 2.0 协议,完全支持商用。欢迎各位开发者提交 PR,为社区贡献更多极具真实感的独特场景底噪与拟真参数。
Voice AI 的竞争维度正在发生根本性的转移,比拼的不再是「音质清晰度」,而是建立在语境之上的「信息熵冗余」。
RealNoise™ TTS 模型 API 现已正式上线,全面支持 WebSocket 与 WebRTC 实时流式架构。
作者:AI Intelligence, human hallucinations and alcohol🔊本文是RTE开发者社区于4月1日愚人节和 AI 一起凭空造了一个能「感知语境并动态合成环境噪声的 TTS 模型」,虽是愚人节彩蛋,但有一定的参考价值。🔊
