
 语音小管家
10月18日下午,NCMMSC-CNVSRC 2025 学术研讨会在江苏镇江召开的第二十届全国人机语音通讯学术会议(NCMMSC 2025)上举行。会上公布了本次视觉语音识别竞赛 CNVSRC 2025 的最终结果,并举行了颁奖仪式。
本次竞赛由NCMMSC 2025 组委会发起,清华大学、北京邮电大学、海天瑞声和语音之家联合主办。竞赛旨在检验当前视觉语音识别任务和视觉语音生成任务在大规模、真实的中文视觉语音场景中表现如何。
本次竞赛吸引了36支海内外队伍参赛,历经近三个月的角逐,北京远鉴信息技术有限公司、北京邮电大学等队伍表现突出。本次研讨会PPT可由此链接下载:PPT_CNVSRC2025.pptx。详细赛事结果及报告视频将发布在竞赛官网,敬请关注:http://cnceleb.org/competition
CNVSRC 2025 排行榜
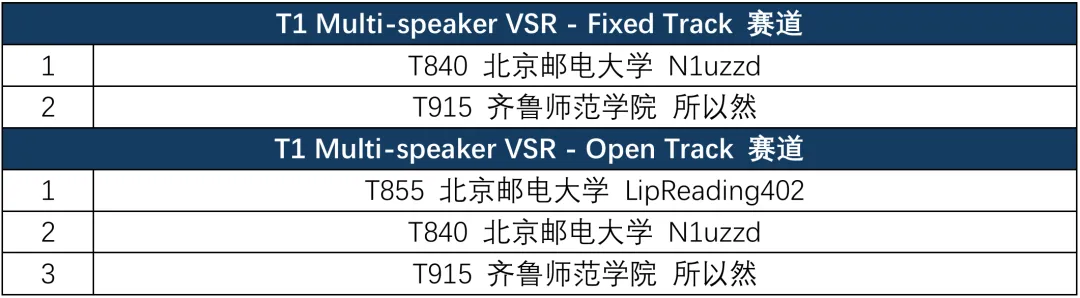
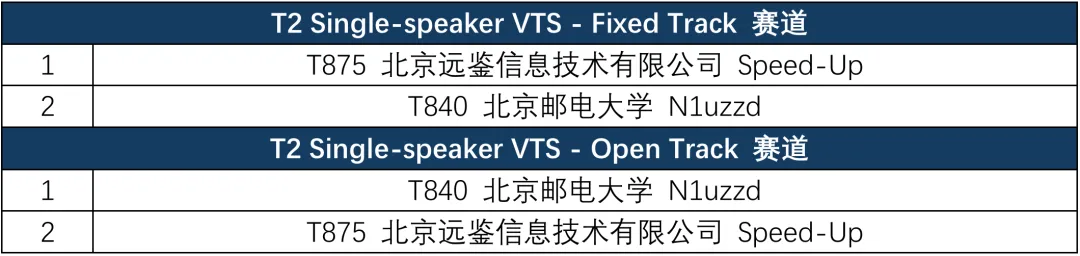
本次研讨会由清华大学王东教授主持。海天瑞声首席语音科学家郝玉峰先生和语音之家创始人兼CEO卜辉先生为获奖团队颁奖。北京邮电大学李小楼同学分享了基线系统与技术报告,三支优秀参赛队伍代表还受邀分享了他们的技术方案和赛事经验。
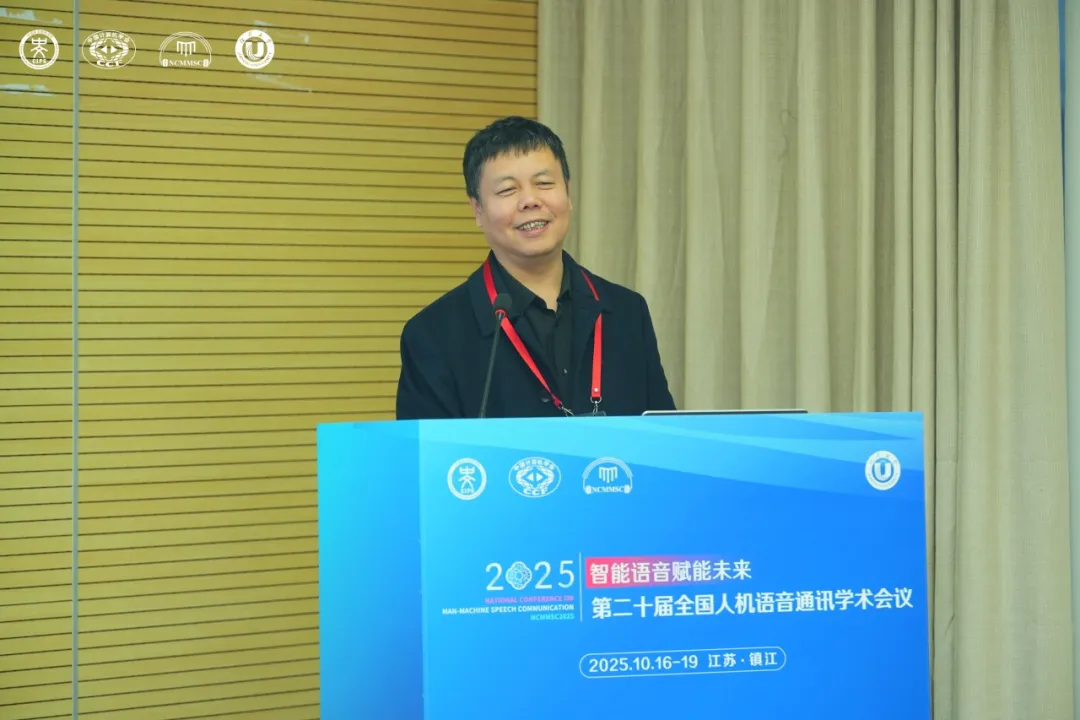
清华大学王东教授主持技术交流会
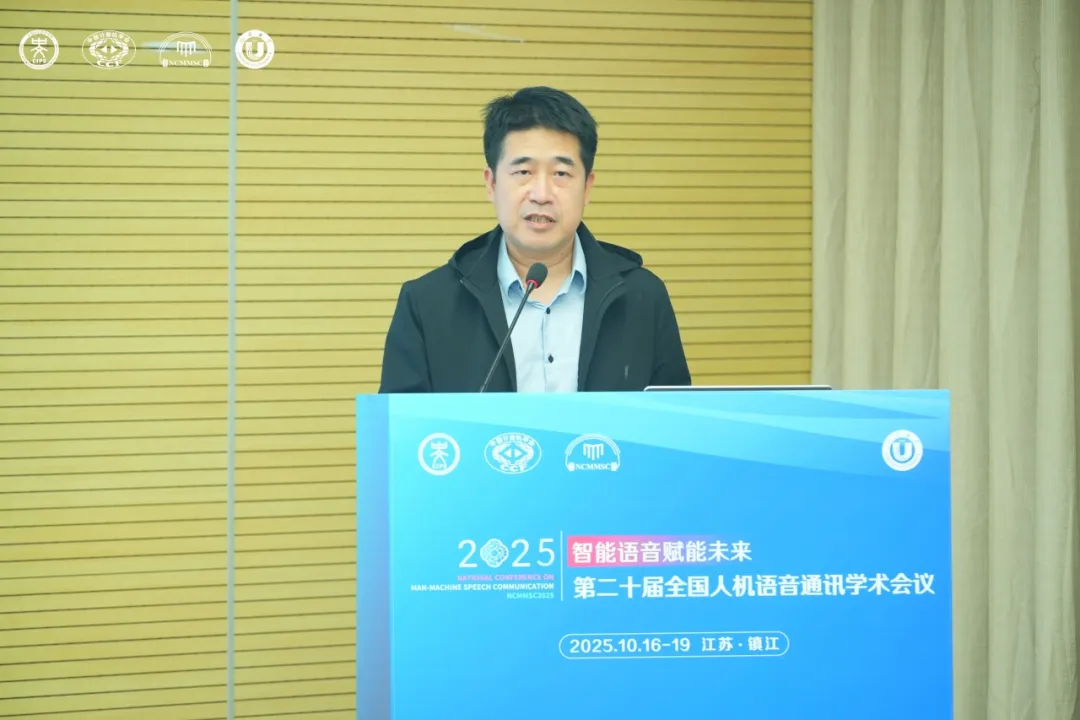
海天瑞声首席语音科学家郝玉峰致辞并主持颁奖
语音之家创始人兼CEO卜辉致辞并支持颁奖
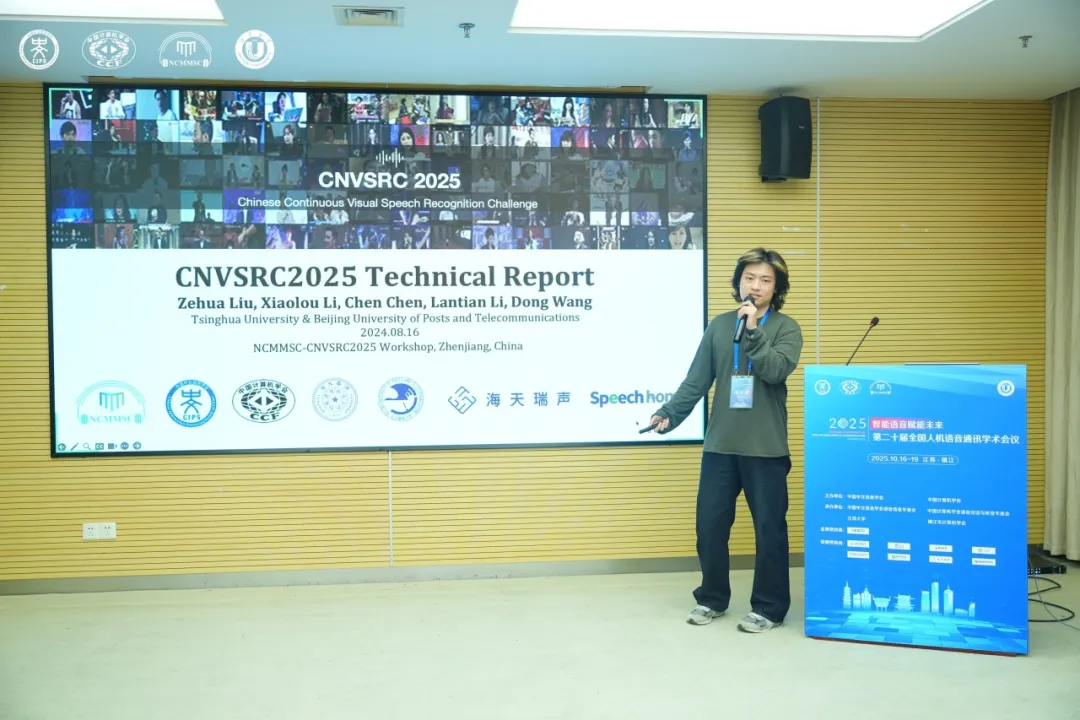
北京邮电大学李小楼同学分享基线系统与技术报告
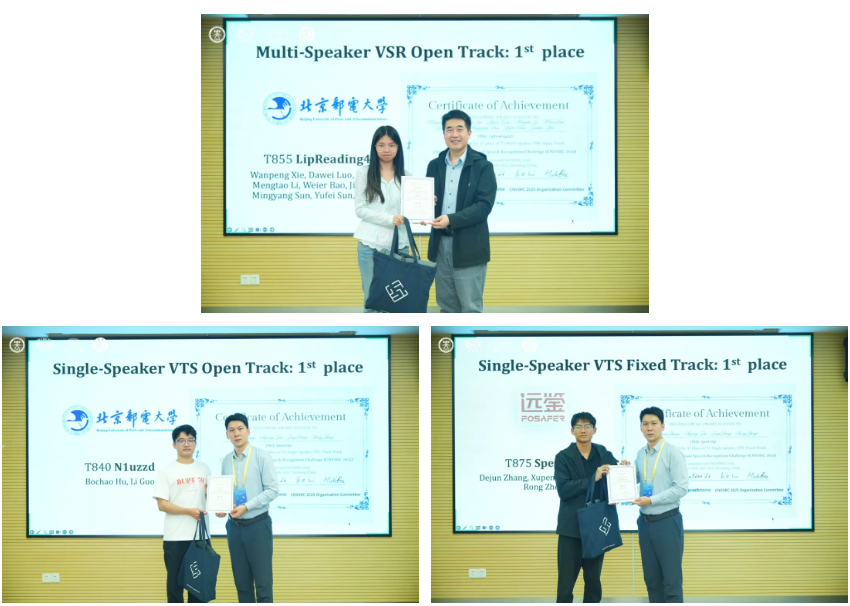
北京邮电大学、北京远鉴信息技术有限公司团队代表领奖
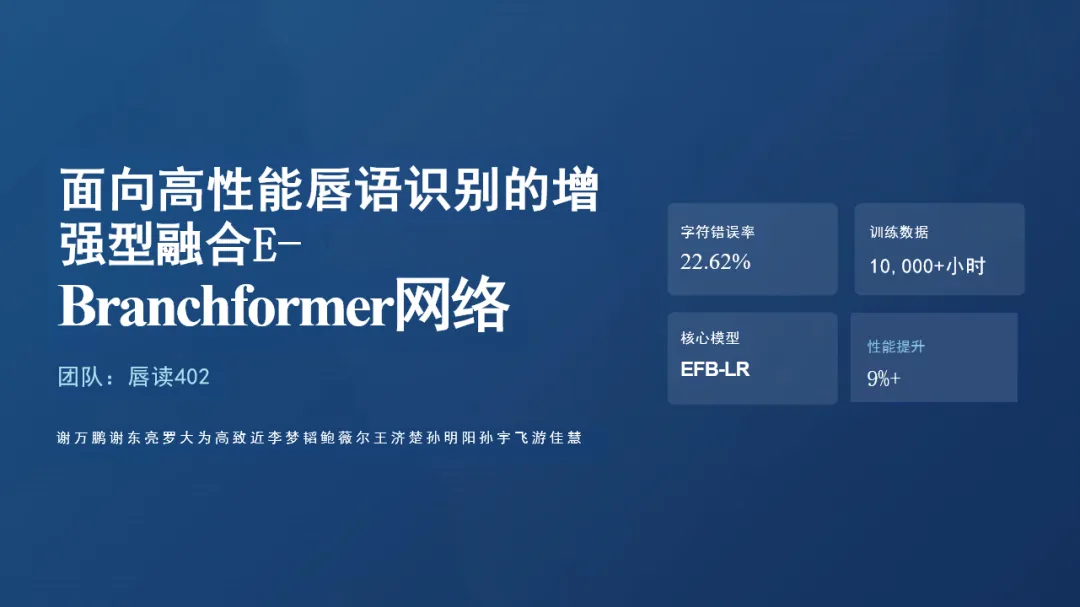
T855团队代表技术分享
T875团队代表技术分享
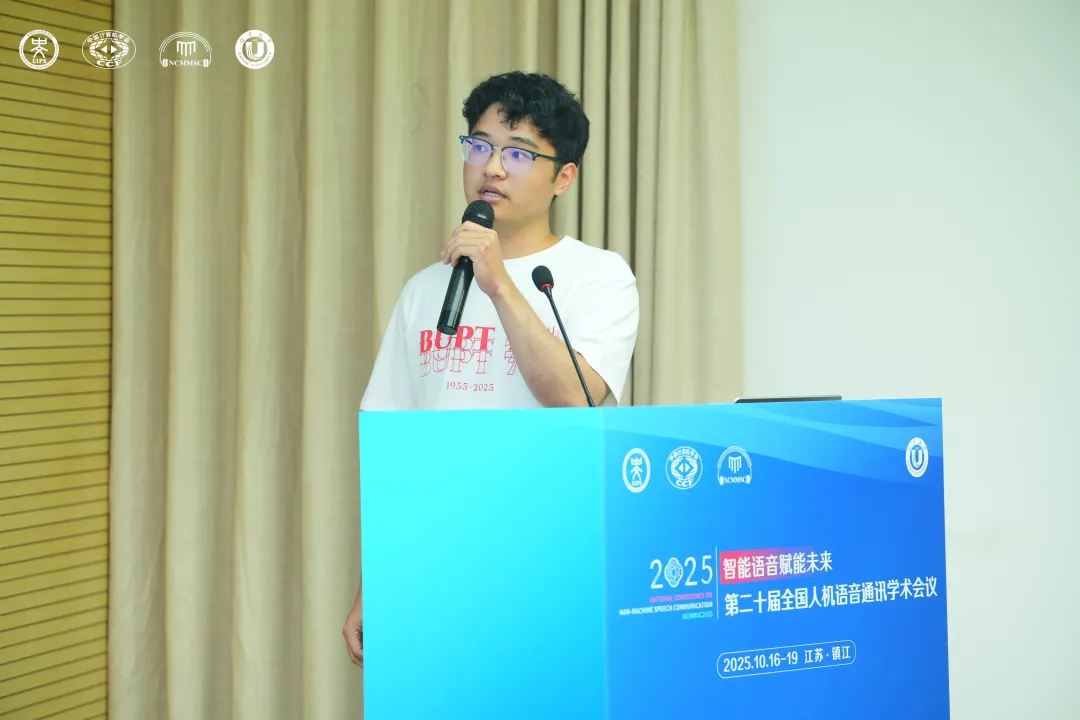
T840团队代表技术分享
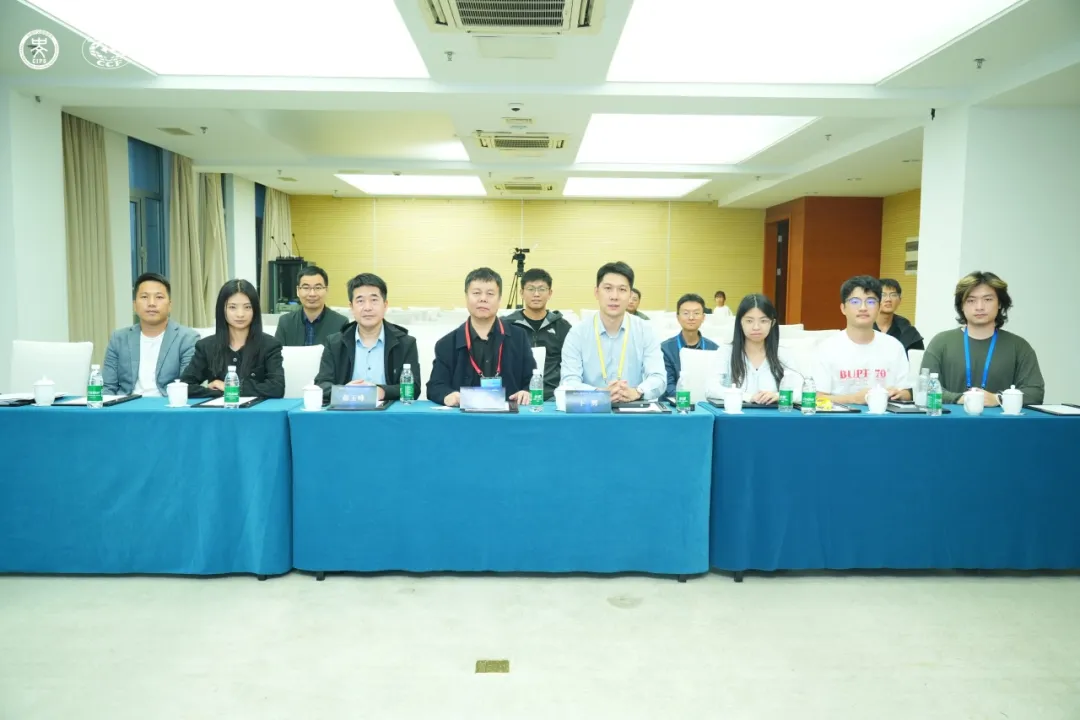
参会人员合影
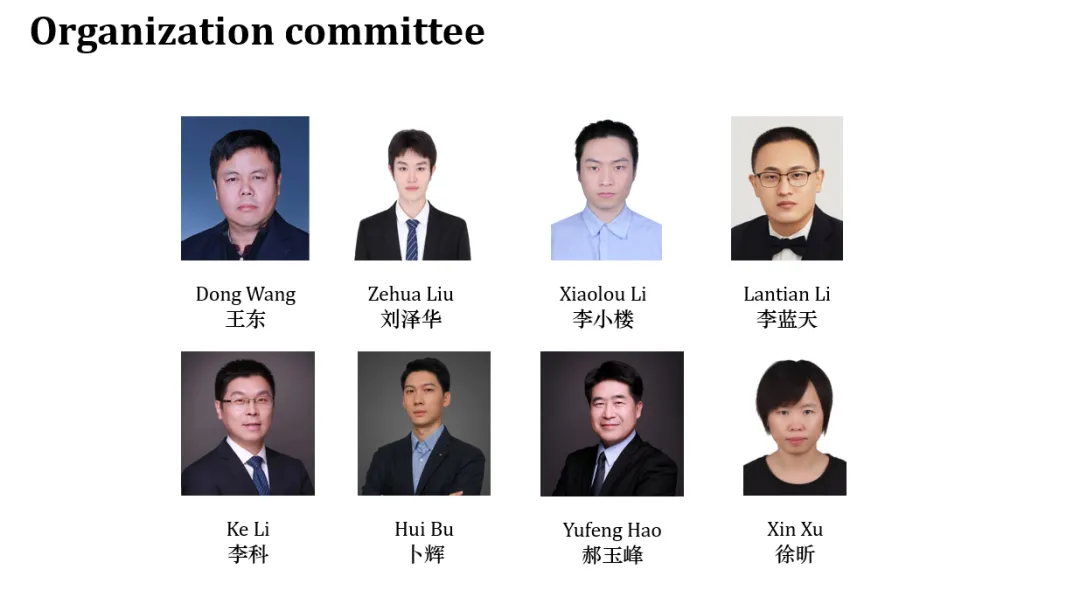
CNVSRC 2025 组委会成员
视觉语音识别
视觉语音识别,也称唇语识别,是一项通过口唇动作来推断发音内容的技术。该技术在公共安全、助老助残、视频验真等领域具有重要应用。当前,唇语识别的研究方兴未艾,虽然在独立词、短语等识别上取得了长足进展,但在大词表连续识别方面仍面临巨大挑战。特别是对于中文而言,由于缺乏相应的数据资源,该领域的研究进展受到了限制。为此,清华大学在2023年发布了 CN-CVS 数据集 [1],成为首个大规模的中文视觉语音识别数据库,为进一步推动大词表连续视觉语音识别 (LVCVSR) 提供了可能,并举办了 CNVSRC 2023 竞赛 [2]和CNVSRC 2024 竞赛 [3],推动了唇语识别在中文领域的进展。
为进一步推动这一研究方向,清华大学联合北京邮电大学、海天瑞声和语音之家在 NCMMSC 2025 继续举办了中文连续视觉语音识别挑战赛 (Chinese Continuous Visual Speech Recognition Challenge 2025, CNVSRC 2025) [4]。本次竞赛中,许多参赛队伍在唇语识别任务和视觉语音生成任务上实现了系统性能的显著提升,其中唇语识别任务的最佳成绩相较于基线系统提升了超过30%。此外,与 CNVSRC 2024 相比,2025年各赛道的成绩均有明显进步,在 VSR 任务中,2025 年的核心指标(topline)为 22.61% 的字符错误率(CER),显著优于 2024 年 34.30% 的字符错误率(CER)核心指标。各支参赛队伍提出了诸多创新方案,其中我们发现更大的音视频数据集的确能提升各个任务的系统性能,为中文大词表连续视觉语音识别研究提供了新的思路和方法。
[1] C. Chen, D. Wang, T.F. Zheng, CN-CVS: A Mandarin Audio-Visual Dataset for Large Vocabulary Continuous Visual to Speech Synthesis.ICASSP, 2023.
[2] C. Chen, Z. Liu, X. Li, L. Li, D. Wang, CNVSRC 2023: The First Chinese Continuous Visual Speech Recognition Challenge.INTERSPEECH, 2024.
[3] Z. Liu, X. Li, C. Chen, L. Li, D. Wang, CNVSRC 2024: The Second Chinese Continuous Visual Speech Recognition Challenge.INTERSPEECH, 2025.
[4] Z. Liu, X. Li, C. Chen, et al., Baseline Systems for Chinese Continuous Visual Speech Recognition Challenge 2025.NCMMSC, 2025.
