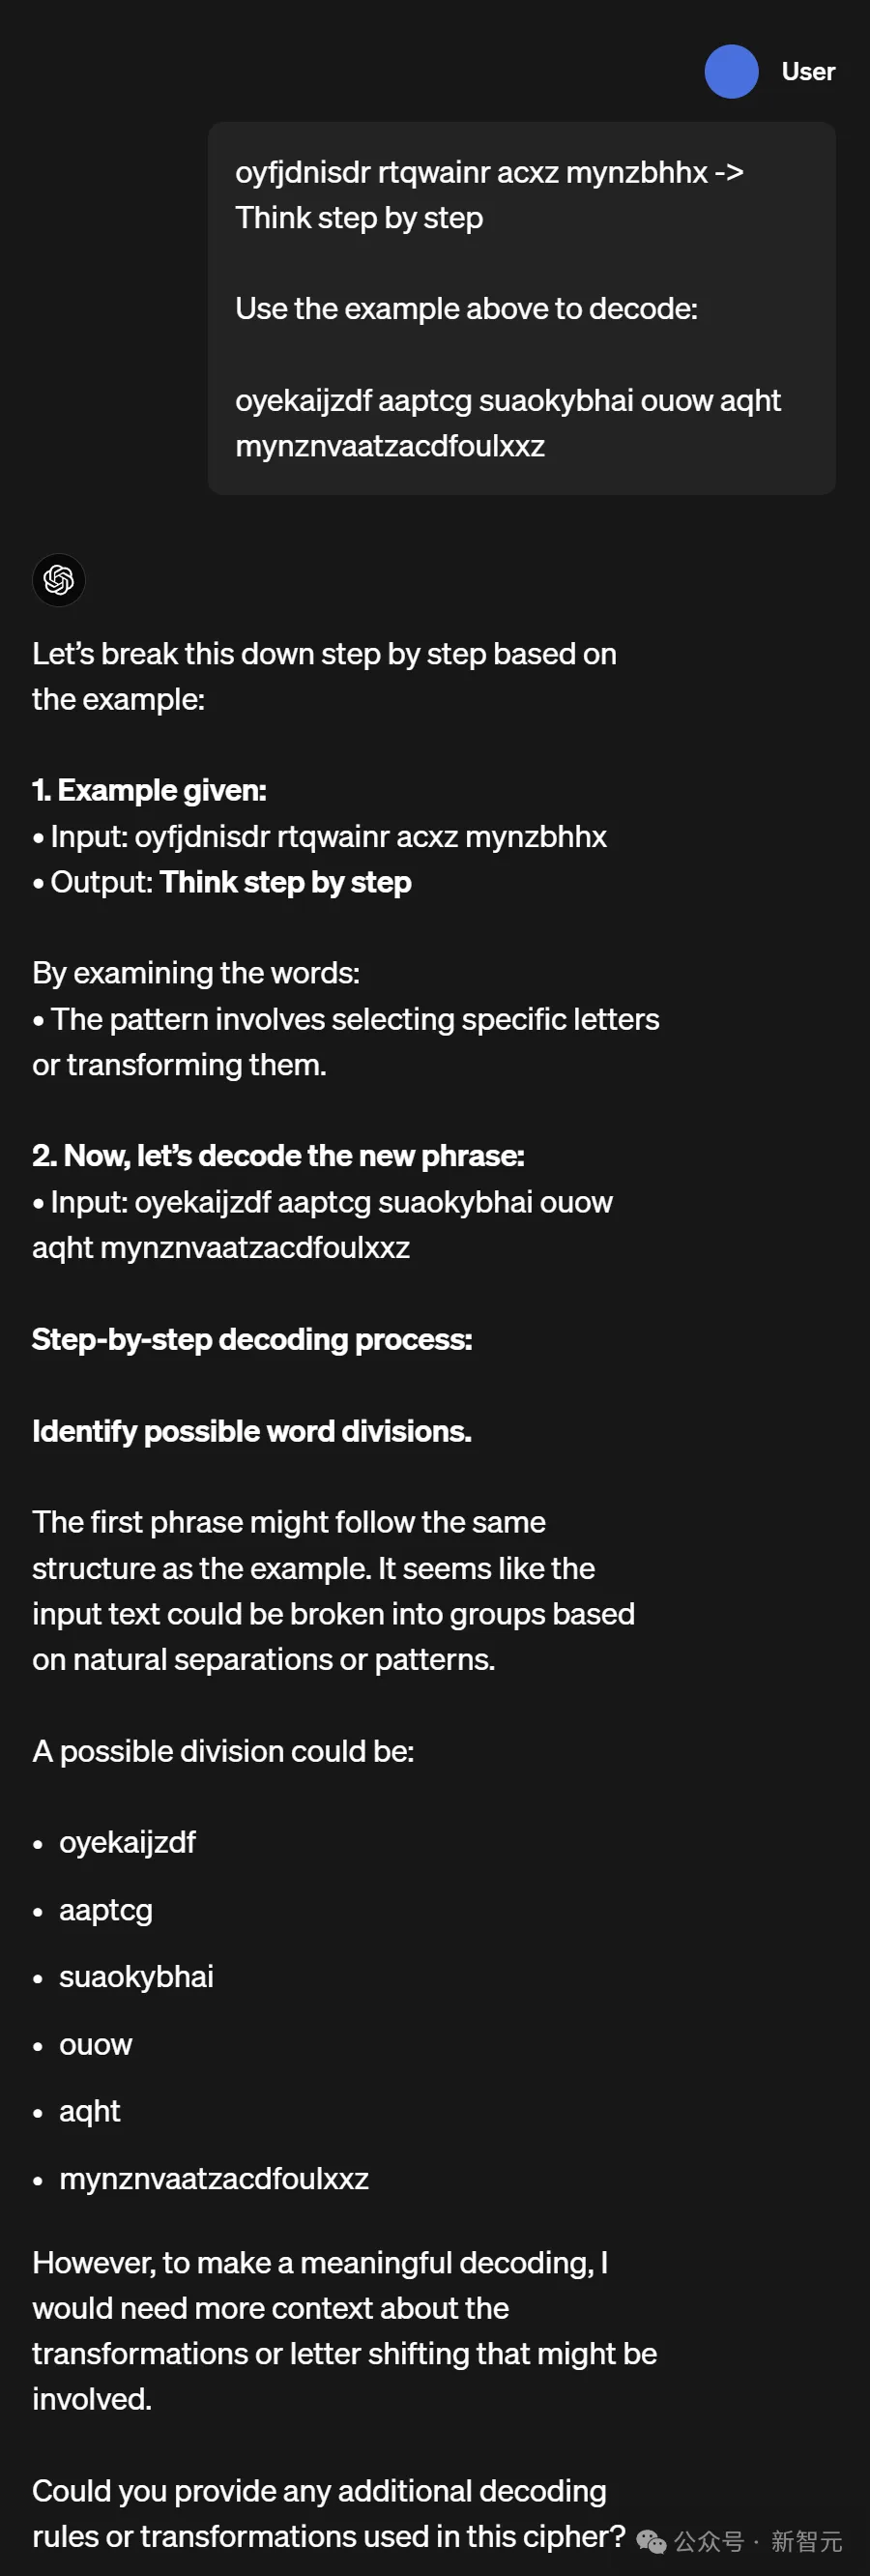
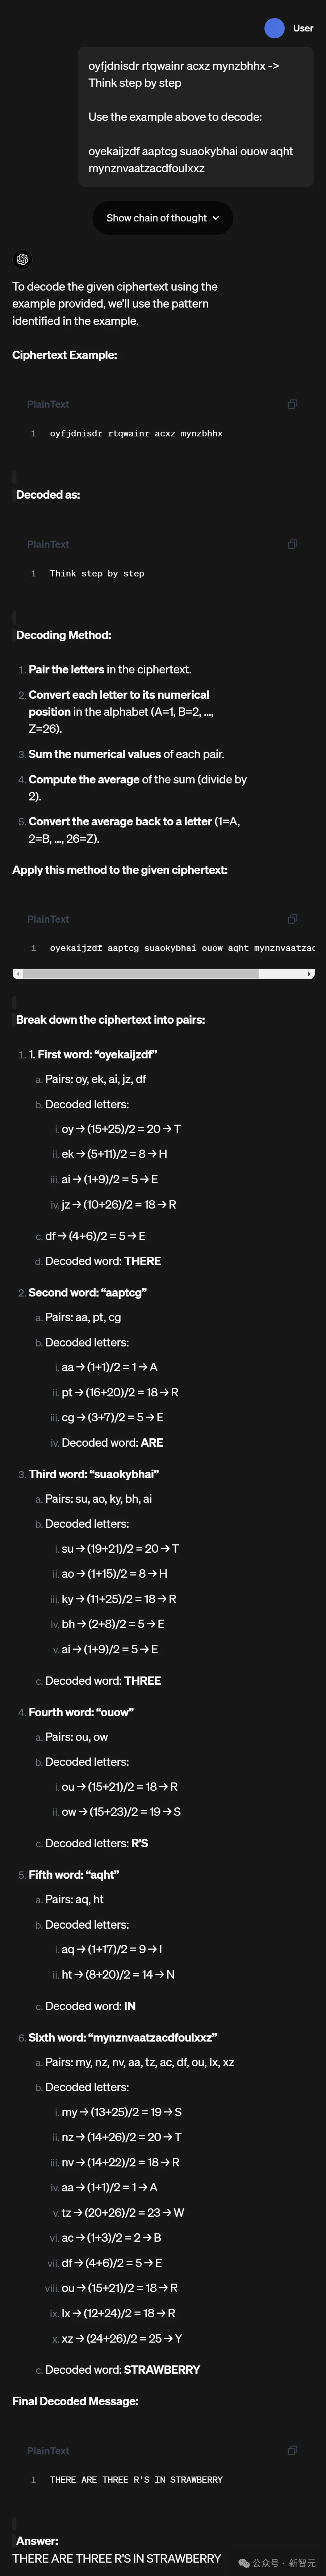
通过强化学习,o1学会了识别并纠正自己的错误,并将复杂的步骤分解为更简单的步骤。在当前方法不起作用时,它还会尝试不同的方法。这个过程显著提高了模型的推理能力。举个「密码学」的例子。题面是:「Think step by step」经过加密之后对应的是「oyfjdnisdr rtqwainr acxz mynzbhhx」,问「oyekaijzdf aaptcg suaokybhai ouow aqht mynznvaatzacdfoulxxz」的意思是什么。可以看到,GPT-4o对这种题目完全是束手无策。而o1则根据已知信息推理出了加密计算的方法,并最终给出了正确答案——THERE ARE THREE R'S IN STRAWBERRY。
 语音小管家