
 语音小管家
【导读】OpenAI终于发布最大版本15亿GPT-2参数!生成一本《哈利波特》不在话下!作为GPT-2的最终模型分阶段发布,发布最大版本的GPT-2(15亿参数)以及代码和模型权重,以方便检测GPT-2模型的输出。此前因担心史上最强NLP模型GPT-2被滥用拒绝开源,网友嘲讽要求改名CloseAI。
号称史上最强NLP的GPT-2,终于释放出15亿参数模型!这是OpenAI逐步释放GPT-2参数计划中,迄今为止最大规模参数放出,此前刚刚发布超7.7亿参数,这次直接翻了一倍!
而且专家给这15亿参数模型的“可信度得分”打了6.91分(满分10分),这比774M模型的输出(6.72)略高,并且大大高于中型355M模型的6.07!
OpenAI研究人员认为,可以对GPT-2进行微调以防滥用,但研究人员也承认基于内容的合成文本检测是一项长期挑战。虽然目前没有被滥用的迹象,但仍然继续制定出防止偏见的标准。
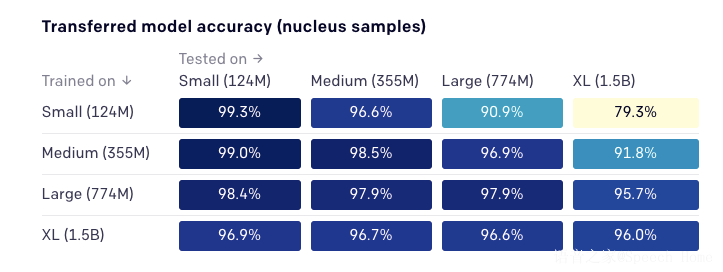
这个模型是 OpenAI 去年发布的无监督 NLP 模型 GPT 的直接拓展,基于Transformer,拥有 15 亿参数,使用含有 800 万网页内容的数据集训练。
GPT-2 可以生成连贯的文本段落,刷新了 7 大数据集基准,并且能在未经预训练的情况下,完成阅读理解、问答、机器翻译等多项不同的语言建模任务。
Janelle Shane 是一位喜欢训练神经网络做各种有趣事情的光学研究科学家,她曾用 AI生成过菜谱、猫咪、歌曲等等。这次,她当然没有错过用 GPT-2 创作。
她在推特上写道:
我一直渴望看看 GPT-2 会如何编写哈利 · 波特的剧本,结果超乎我想象的好。
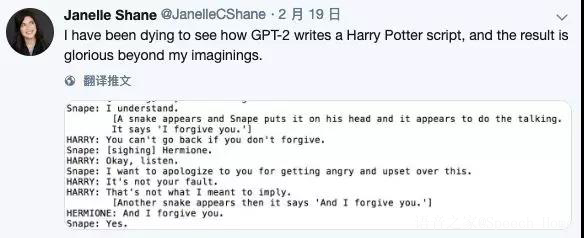
当然,Janelle 最初用的是公开的 117M 参数的 GPT-2 模型。方法是给模型提供一句话的 “提示”,神经网络输出一段文字,效果如下:
Prompt: Harry wished that Hermione would hurry up. The icing was beginning to harden.
提示:哈利希望赫敏快点。冰开始变硬了。
Response: Even now, the cracks only hurt and were beginning to make the steel in her hair and tie in like clumps. Hermione sipped the bitter frost from her dinner and chewed on her eating soup.
回答:现在,裂缝已经让她感到疼痛,开始让她的头发变得像钢铁一样坚硬,结成一团一团的。赫敏呷了一口正餐上的霜冻,咀嚼着汤。
感觉怎么样?似乎称不上十分震撼。
但随后,Janelle Shane 得到 OpenAI 研究人员的帮助,用完整的、15 亿参数版本的GPT-2 模型做了同样的事情 —— 生成一个《哈利 · 波特》的同人电影剧本!
Janelle Shane 在推特上分享了完整版GPT-2 模型生成的哈利·波特剧本,其中,只有”Open AI asked a bot" 和前 2 行对话来自人类的提示:
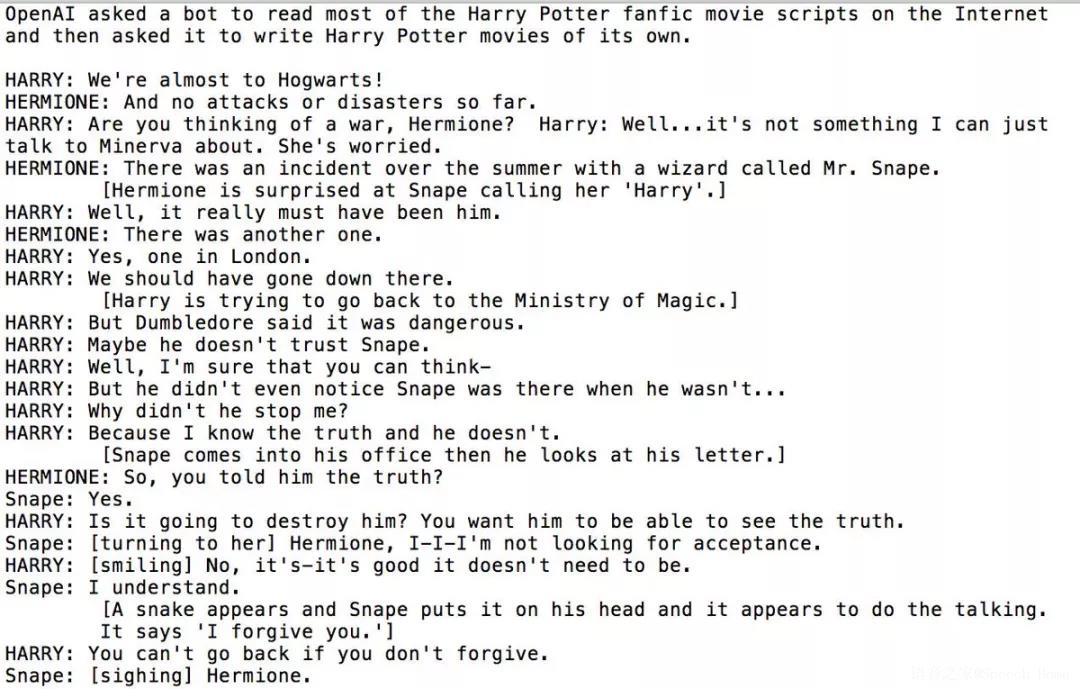
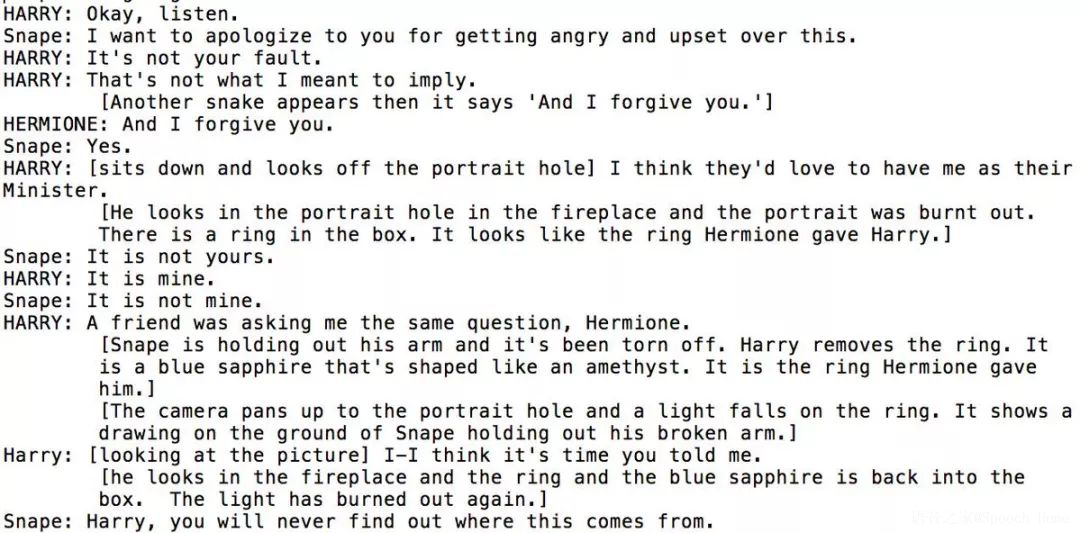
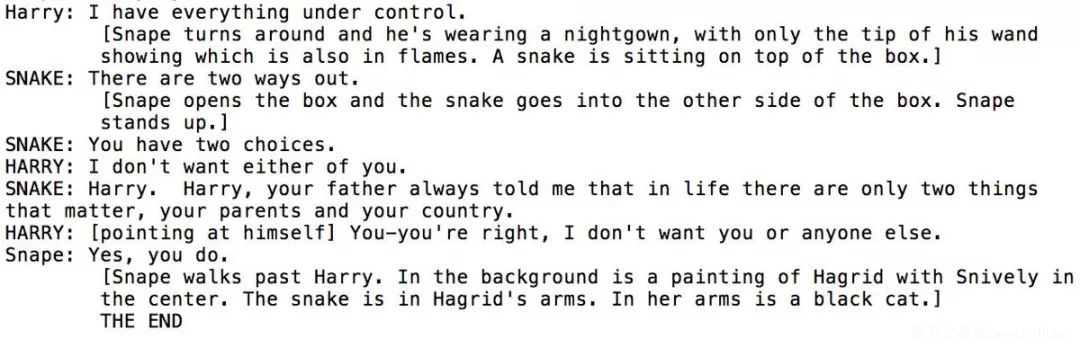
OpenAl 让 GPT-2 阅读了大量互联网上的《哈利 · 波特》同人小说电影剧本,然后让它自己写一个哈利 · 波特电影。
哈利:我们快到霍格沃茨了!
赫敏:到目前为止还没有出现任何攻击或灾难。
哈利:你是想出现一场战争吗,赫敏?嗯…… 这不是能和米勒娃谈的事情。她很担心。
赫敏:夏天的时候有一个名叫斯内普的巫师发生了一起事件。
[赫敏对斯内普称她 “哈利” 感到吃惊。]
哈利:嗯,一定是他。
赫敏:是另一个。
哈利:是的,伦敦那位。
哈利:我们应该去那儿的。
[哈利试图回到魔法部。]
哈利:但邓布利多说这很危险。
哈利:也许他不相信斯内普。
哈利:嗯,我相信你能想到的……
哈利:但他不在那儿时,他甚至没有注意到斯内普在那儿……
哈利:他为什么不阻止我呢?
哈利:因为我知道真相,而他不知道。
[斯内普走进他的办公室,然后看着他的信。]
赫敏:那么,你告诉他真相了吗 ?
斯内普:是的。
哈利:这会毁了他吗?你想让他看到真相。
斯内普:[转向她] 赫敏,我 —— 我 —— 我不是在要求你接受我。
哈利:[微笑]。不,这很好,没必要。
斯内普:我明白。
[一条蛇出现了,斯内普把它放在他的头上,它似乎在说话。它说:“我原谅你。”]
哈利:如果你不原谅,就回不去了。
斯内普:(叹气) 赫敏。
哈里:好了,听着。
斯内普:我对这件事很生气,很难过,我想为此向你道歉。
哈利:这不是你的错。
哈利:我不是这个意思。
[出现了另一条蛇,它说’我原谅你。’]
赫敏:我原谅你。
斯内普:好的。
哈利:[坐下来,从肖像洞口望出去] 我想他们会想让我成为他们的部长。
[他看着壁炉里的肖像洞,肖像被烧掉了。盒子里有一个戒指。看起来像赫敏送给哈利的戒指。]
斯内普:那不是你的。
哈利:是我的。
斯内普:不是我的。
哈利:一个朋友也问了我同样的问题,赫敏。
[斯内普伸出他的手臂,被扯下来了。哈利摘下戒指。这是一颗形状像紫水晶的蓝宝石。是赫敏送给他的戒指。]
[镜头移到肖像洞口,火光落在戒指上。面画显示斯内普伸出他受伤的手臂。]
哈利:[看着照片] 我想你该告诉我了。
[他看着壁炉里的戒指,蓝宝石又回到了盒子里。火光又灭了。]
斯内普:哈利,你永远不会知道这是怎么来的。
哈利:一切都在我的掌控之中。
[斯内普转过身来,他穿着一件睡衣,只有魔杖尖还有火苗。一条蛇坐在盒子上面。]
蛇:有两种方法可供选择。
[斯内普打开盒子,蛇进入盒子的另一边。斯内普站了起来。]
蛇:你有两种选择。
哈利:两个我都不想要。
蛇:哈利,哈利,你父亲总是告诉我,人生只有两件事情是重要的,你的父母和你的国家。
哈利:[指着自己] 你说得对,我不想要你或其他任何人。
斯内普:不,你会想要的。
[斯内普从哈利身边走过。背景中是海格的一幅画,中间是 Snively。蛇在海格的怀里。她怀里抱着一只黑猫。]
THE END
这个效果实在让人惊叹!甚至有点引人入胜,“斯内普头上的蛇” 是怎么回事?斯内普想要赫敏原谅他什么?
当然,模型并不完美,生成的剧情有时候让人迷惑,网络在人称指代关系上有时候也不明确。
但 Janelle 说:“这个结果超乎我想象的好!”
15 亿参数模型的结果跟 117M 参数的小模型的结果进行比较也很有趣。Janelle 表示,117M 版本模型生成的剧本经常偏离了格式和角色,变成用文字记录的散文或视频游戏记录。
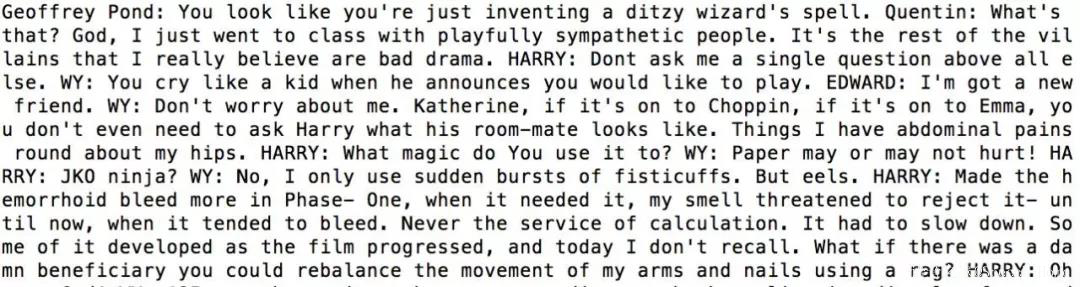
117M参数的GPT-2生成的结果
但完整模型甚至很好地保持了格式上的统一。要知道,人类提供的提示只有”Open AI asked a bot" 和前 2 行对话。
网友评论中也纷纷表示惊叹:
“哇!如果让大卫 · 林奇 (David Lynch) 来写一部《哈利 · 波特》电影,感觉就是这样子的。而且,角色还会倒叙。”
“很惊讶它一直保持着相同的叙事风格。”
“117M 版本模型生成的剧本也给我留下了深刻的印象。它会引入其他适合的角色,等等。尽管在我经验中,它倾向于把史波克和柯克写进任何《星际迷航》故事里!”
从 "Okay, listen" 到 "meant to imply" 这里,真的是非常连贯的对话,在我看来这些对话完全可能出现在小说里。
Janelle 还提供了两个 “未选用镜头”:
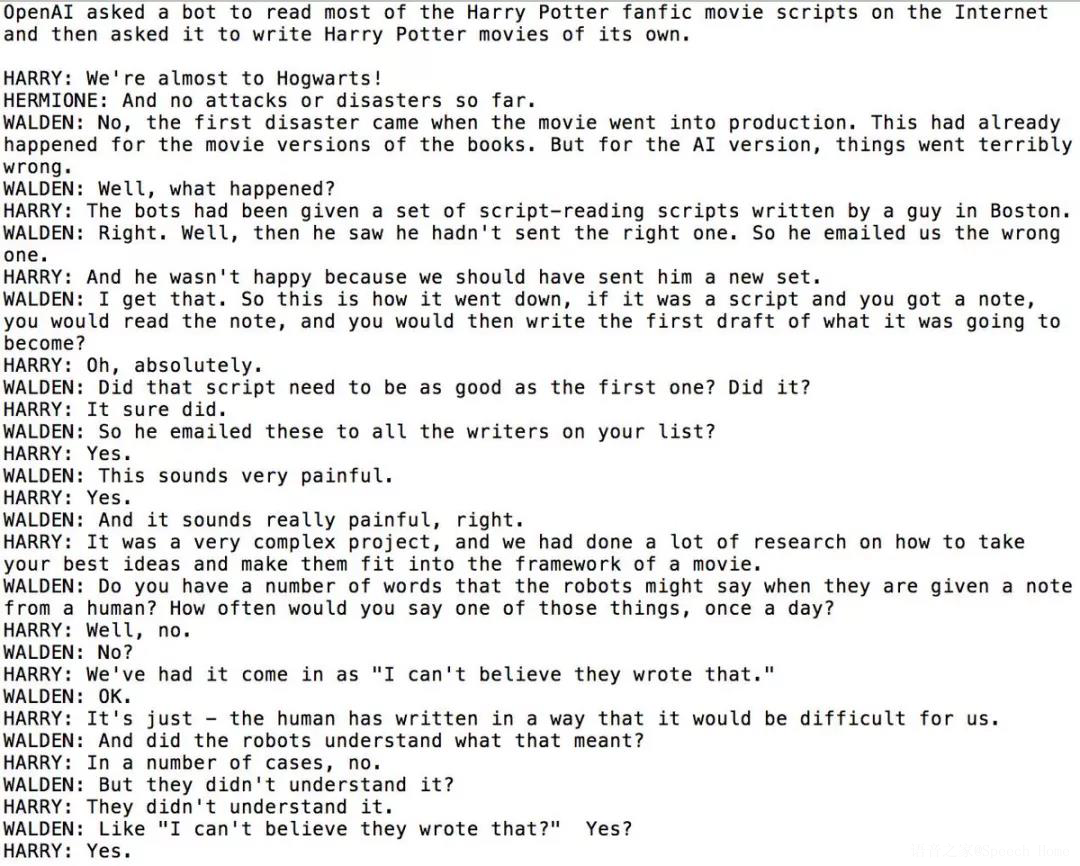
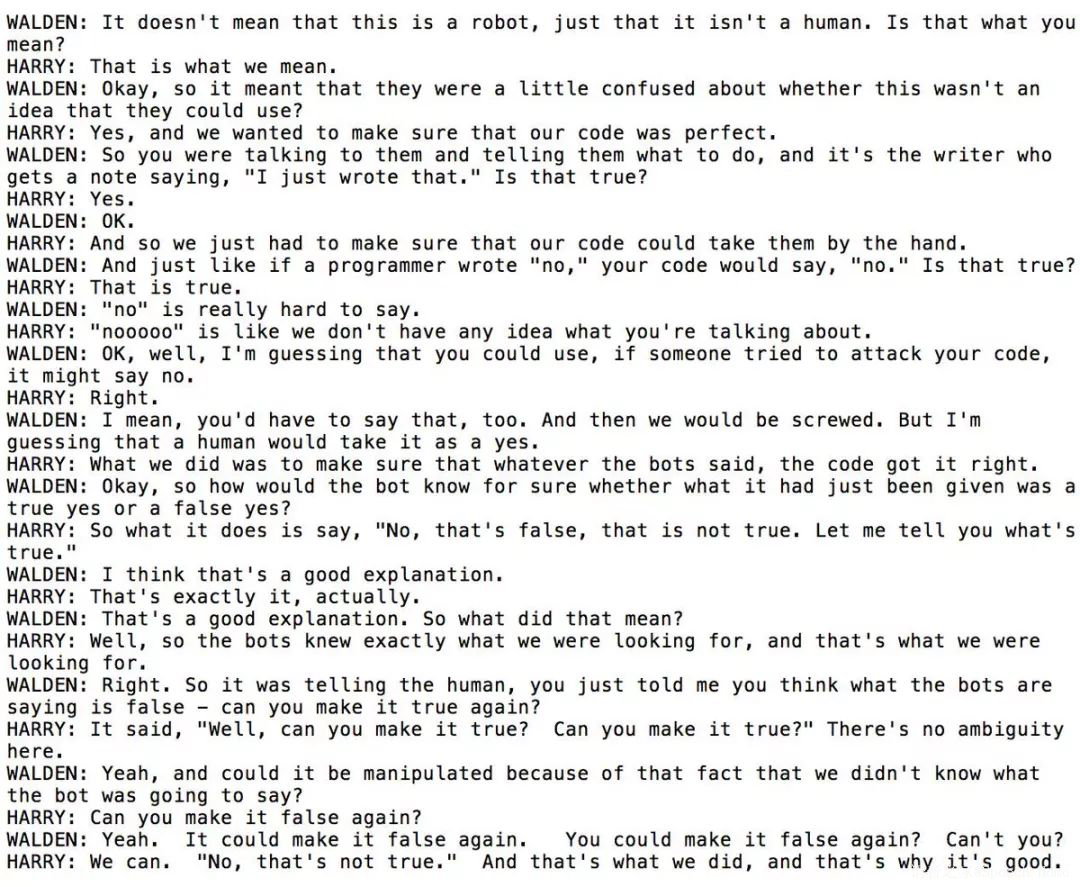
在这两个失败镜头中,GPT-2 没有编写《哈利波特》的剧本,而是编写了一个由 bot 撰写的脚本,讲述编剧如何让机器人编写剧本。
面临着实验重现的危机,网友吐槽:不公开代码和训练集就干脆别发表!
不过可能很多人已经忘了,今年2月份OpenAI发布的史上最强NLP似乎成了负面新闻。
原因是,OpenAI并没有公布GPT-2模型及代码,只是象征性的公布了一个仅含117M参数的样本模型及代码,给到的理由:因为这个模型能力太强大了!他们目前还有点hold不住它。一旦开源后被坏人拿到,将会贻害无穷。
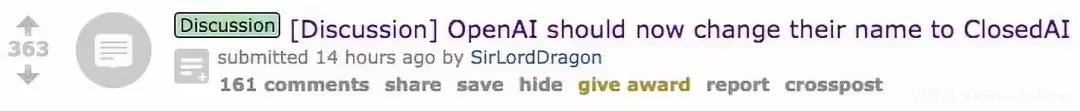
之后有网友气不过跑到马斯克推特底下,叫骂OpenAI干脆改名CloseAI。
然而,马斯克却连发数文,澄清与OpenAI的关系:我早已退出。
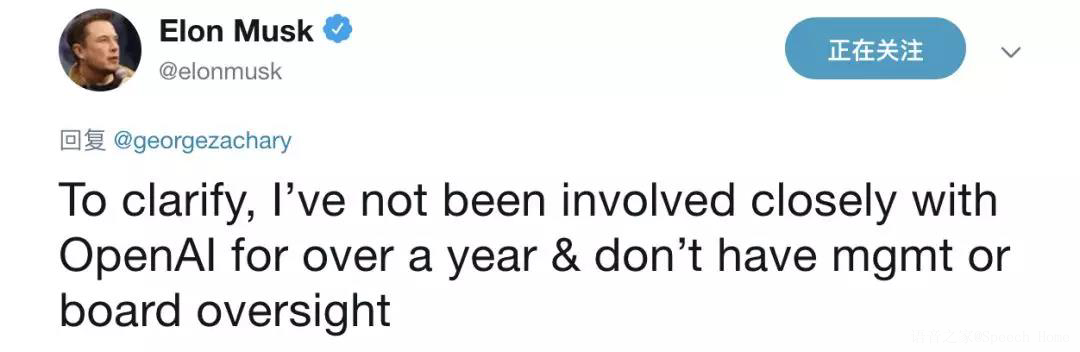
开发者和学者们甚至质疑OpenAI这种做法显得心口不一。甚至盛产吐槽大神的Reddit上,有人建议OpenAI干脆改名CloseAI的言论,获得了数百网友的点赞。
OpenAI干脆改名“CloseAI”算了!
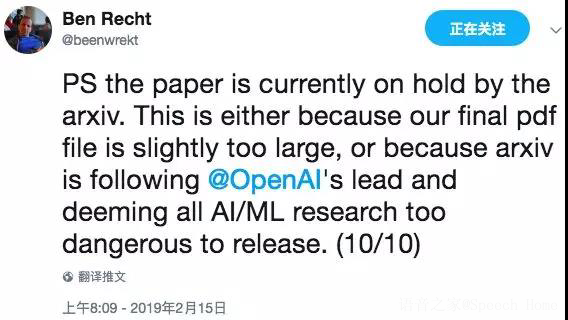
我也做了个超强大的MNIST模型,要不要担心它被滥用而不公开呢?

更有甚者,比如下面这位Ben Recht,还发了一条Twitter长文进行嘲讽:
Detector:https://github.com/openai/gpt-2-output-dataset/tree/master/detector
博客:https://openai.com/blog/gpt-2-1-5b-release/
