
开源!OSUM-EChat — 语音理解驱动的端到端共情口语对话生成模型

共情(Empathetic)能力是实现自然人机语音交互的核心要素,其核心在于使机器能够感知并理解用户输入语音中的各类副语言信息(如年龄特征、性别相关语音特质、情绪状态及声音事件等),进而作出贴合用户状态的共情回应。近年来,端到端语音语言模型…
26 0 0

共情(Empathetic)能力是实现自然人机语音交互的核心要素,其核心在于使机器能够感知并理解用户输入语音中的各类副语言信息(如年龄特征、性别相关语音特质、情绪状态及声音事件等),进而作出贴合用户状态的共情回应。近年来,端到端语音语言模型…
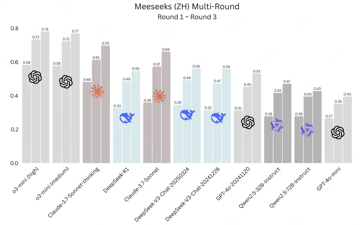
来源丨美团技术团队 针对大模型知识推理能力与指令遵循能力存在表现差异的现象,为推进指令遵循能力的系统化研究与精准评估,美团 M17 团队推出全新评测基准 Meeseeks,并在魔搭社区、GitHub、Huggingface等开源平台上线。…


ChatGPT、DeepSeek 等语言模型具备「深度推理」(Reasoning)能力,这类模型会在回答问题前先进行一段较长的推论过程,使回答的品质大幅提升。 不过,这种「先停下来思考再作答」的方式,虽然能产生更高品质的回应,却不太适用于需…

来源丨AI音频时代 近日,Meta 公司最新推出的Reels短视频AI音频翻译功能有了创造性突破。同一时间Meta正式为Facebook和Instagram的Reels功能推出了AI语音翻译功能。 Meta AI翻译功能最大亮点在于,它采用…


实时语音转文字(ASR)和说话人识别(Diarization)在多人会议、字幕生成和无障碍辅助中需求日益增长,但传统工具常需云端处理,存在隐私风险和延迟问题。 最近 GitHub 上出现了一款开源项目WhisperLiveKit,提供了完全…


来源丨AIGC开放社区 近日,微软研究院开源了创新音频模型 VibeVoice-1.5B。 VibeVoice-1.5B开创了语音界多个重大技术突破:一次性可连续合成90分钟超长逼真语音,之前多数模型只能合成60分钟以内语音,并且30分钟后…
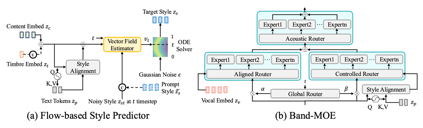
歌曲生成的核心是基于各种提示生成可控的高质量歌曲。然而,现有方法难以生成具有提示控制的人声和伴奏,且不能实现两者间很好的对齐。此外,它们在支持多种歌曲相关的任务方面,如歌声风格迁移,人声配伴奏,也存在不足。 为解决这些挑战,来自浙江大学的学…
