不用 ASR,TTS也能知道自己说到哪了!自变量X2-NativeCursor 开源

你让一个全双工 AI 助手“从 1 数到 100”。它采用 token 级流式 TTS(文字转语音):大模型生成数字序列,TTS 持续合成,播放器一边接收一边播放。 假设大模型已经生成了完整的数字序列,声音却刚播到 27: 模型已经生成:1…
29 0 0

你让一个全双工 AI 助手“从 1 数到 100”。它采用 token 级流式 TTS(文字转语音):大模型生成数字序列,TTS 持续合成,播放器一边接收一边播放。 假设大模型已经生成了完整的数字序列,声音却刚播到 27: 模型已经生成:1…
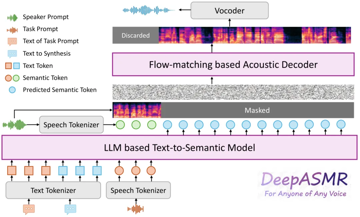
本期推送将介绍上海交通大学听觉认知与计算声学实验室与 VUI Labs 联合完成的研究论文《DeepASMR: LLM-Based Zero-Shot ASMR Speech Generation》,分享一项基于大语言模型的零样本 ASMR…
今日论文合集:CS.SD语音与音频 | 共 9 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测 1…
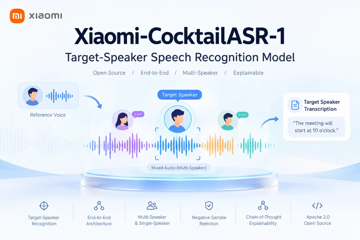
在多人同时说话的场景里,语音识别一直面临一个特殊问题:系统能够听见很多声音,却很难判断其中哪一句属于指定的人。 会议录音、多人通话、车载语音、家庭环境中的语音控制,都存在类似情况。传统方案通常需要先进行语音分离,再把分离后的目标声音交给 A…
今天,阶跃正式发布 Step Audio 3 系列模型,包括 StepAudio 3 Realtime、StepAudio 3 ASR、StepAudio 3 TTS、StepAudio 3 Gen 和 StepAudio 3 Music。…
全国人机语音通讯学术会议(National Conference on Man-Machine Speech Communication, NCMMSC)是中国计算机学会(CCF)和中国中文信息学会(CIPS)联合主办的我国语音科学与技术领…
今日论文合集:CS.SD语音与音频 | 共 30 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
今日论文合集:CS.SD语音与音频 | 共 9 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音合成与声音生成 2…
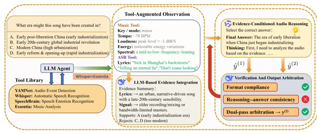
分享天津大学认知计算与应用重点实验室9篇论文被INTERSPEECH 2026 录用的论文。本次录用工作覆盖大音频语言模型、音频推理智能体、阿尔茨海默病语音检测、鲁棒说话人验证、上下文表现力语音评估以及自监督语音表征学习等方向。 ⏩1. M…
今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
