语音识别系列——特征部分(二)

本文主要来跟大家说下基于深度学习的一种特征,瓶颈特征(bottleneck)。此外,还有一个名词叫tandem,这个意思就是把bottleneck特征跟mfcc特征或者plp特征合并在一起使用,往往这么使用效果更好。下面介绍2种bottle…
171 0 0

本文主要来跟大家说下基于深度学习的一种特征,瓶颈特征(bottleneck)。此外,还有一个名词叫tandem,这个意思就是把bottleneck特征跟mfcc特征或者plp特征合并在一起使用,往往这么使用效果更好。下面介绍2种bottle…
语音本质是声带的振动,然后经过声道和口腔的调制才产生我们可以听到或拾取的声音,然而通过倒谱(cepstrum)分析语音就能将这一本质的特征参数提取出来。 梅尔倒频谱(Mel-Frequency Spectrum, MFC)是一个可用来代表短…
今天给大家说下如何利用kaldi搭建说话人识别的例子。仅仅是搭建,具体的很多参数的调整需要大家根据数据集的不同慢慢调整。 数据准备:无论使用kaldi来做语音识别还是说话人识别,第一步就是数据准备,对于说话人识别来说,需要准备的几个文件为w…
语音识别分为训练和识别两个过程,训练包含声学模型的训练和语言模型的训练,识别就是大家说的那个过程。通常会通过麦克风来获取音频,这部分一般是系统函数调用获取得到音频数据,一般系统采用16k采样率,16bits,单通道的音频。当然也可能会用到高…
前言 Uni-WaveNet 实现方案 IAF:Inverse Autoregressive Flow WaveNet 配置 IAF WaveNet 配置 Spectrogram 代价函数设计 训练和优化 IAF samples AB Te…
1、前言 语音合成系统分为前端和后端,前端负责分词、词性、多音字标注等文本特征信息提取;后端模块根据前端提取的文本特征完成语音生成。从技术角度,传统后端模块又可以细分为拼接系统和参数系统,拼接系统和参数系统各有优缺点,详细对比可以参照 AI…
一、语音合成技术简介 语音合成,通常又称文语转换(Text To Speech,TTS),是一种可以将任意输入文本转换成相应语音的技术,是人机语音交互中不可或缺的模块之一。如果说语音识别技术是为了让机器能够“听懂”人说话,那么语音合成技术则…
引言 整体架构 平台基础层 分布式文件存储系统 控制中心 平台日志与实时监控系统 镜像管理系统 总结 参考 — 引言 — 在 AI 计算:
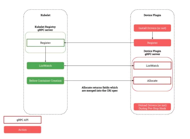
引言 Kubernetes Kubernetes 的 GPU 资源管理与调度 Device Plugin 准备工作 设备注册 设备分配 设备回收 Device Manager 用户使用 回顾与展望 总结 参考 本篇介绍如何利用 Kubern…
摘要:很多小伙伴在初步尝试如何通过 Horovod 实现 TensorFlow 的线性加速的过程中,可能会碰到两个问题:第一个是 TensorFlow 从零开始安装配置的过程比较繁琐,第二个问题是上一篇的示例是通过集群的方式运行 Horov…