Xiaomi MiMo-V2.5 系列大模型开启公测

以下文章来源于Xiaomi MiMo 今天凌晨,Xiaomi MiMo-V2.5 系列模型正式开启公测。 Xiaomi MiMo-V2.5 系列包含 MiMo-V2.5、V2.5-Pro 、V2.5-TTS Series 、V2.5-ASR…
21 0 0

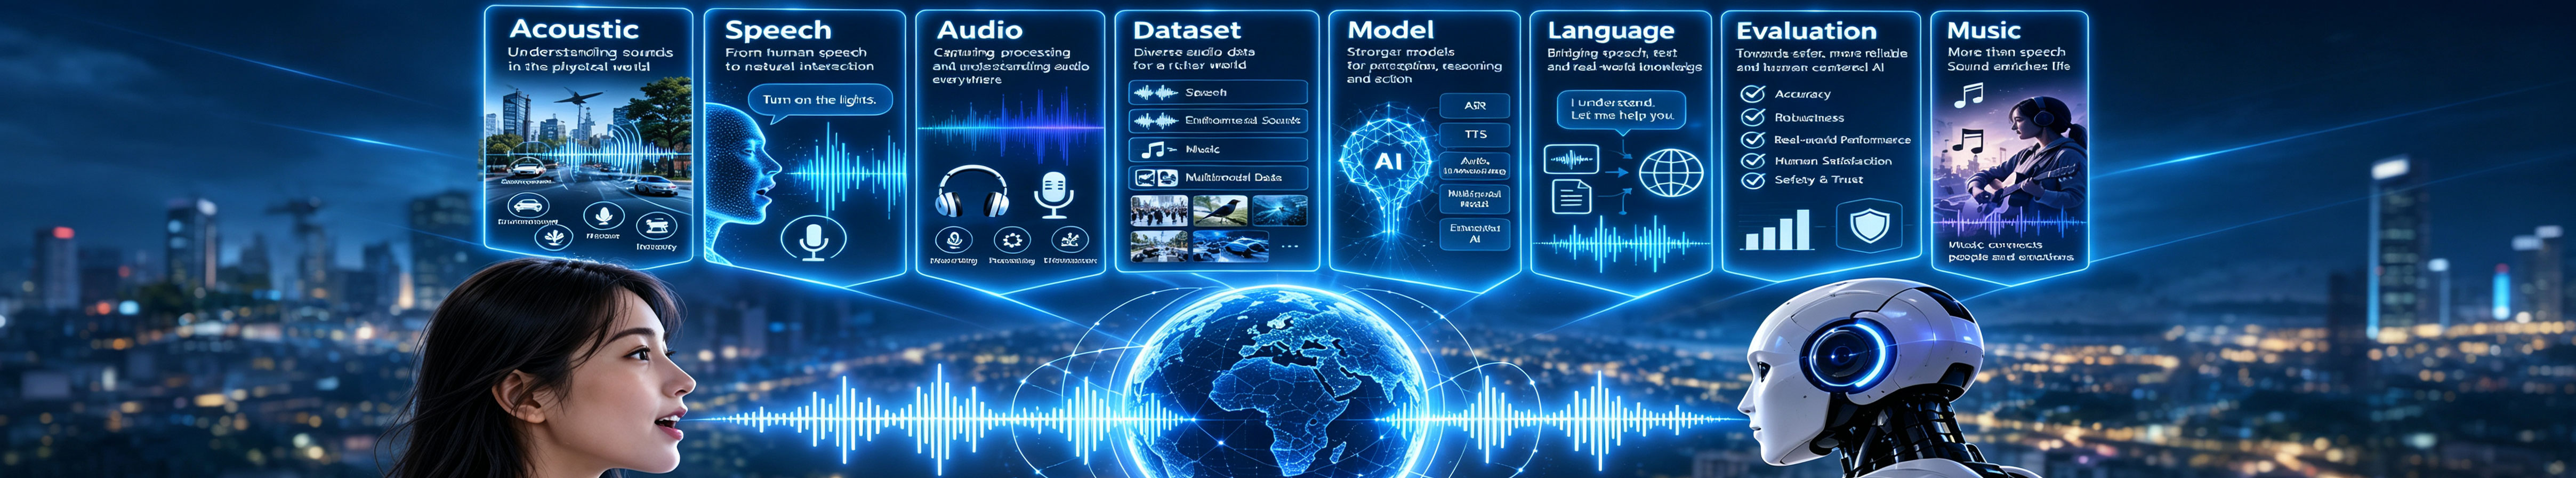
以下文章来源于Xiaomi MiMo 今天凌晨,Xiaomi MiMo-V2.5 系列模型正式开启公测。 Xiaomi MiMo-V2.5 系列包含 MiMo-V2.5、V2.5-Pro 、V2.5-TTS Series 、V2.5-ASR…
昨晚,千问3.6系列最新模型Qwen3.6-27B正式开源! 该模型在核心编程能力评测中,以270亿的总参数量,性能媲美千亿参数级别模型。在SWE-bench、Terminal-Bench 2.0、SkillsBench、QwenWebBe…
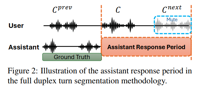
文章链接:https://arxiv.org/pdf/2511.10262 仓库链接:https://github.com/ZhangHe0918/MTR-DuplexBench 数据集链接:https://huggingface.co/d…
本次分享内容为内蒙古大学23 级硕士研究生 鲜鹄鸿、内蒙古大学刘瑞教授与美国约翰霍普金斯大学 Berrak Sisman、香港中文大学(深圳)/河套学院 李海洲教授合作发表于 APSIPA ASC 2025 的工作《NE-PADD: Lev…
论文标题: Qwen3.5-Omni Technical Report 论文链接: https://arxiv.org/abs/2604.15804v1 代码链接: https://modelscope.cn/studios/Qwen/Qw…
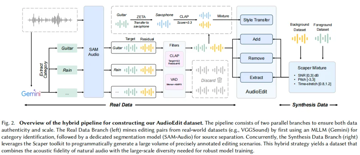
本次分享由内蒙古大学24级博士生张锦华、内蒙古大学刘瑞教授与香港中文大学(深圳)/ 深圳河套学院 李海洲教授合作发表在IEEE Transactions on Audio, Speech and Language Processing 20…
通义实验室正式推出 Fun-ASR1.5, 实现了「方言工业级可用」的语音识别大模型 。 它基于统一的大模型架构,单模型即可无缝覆盖30种语言、汉语七大方言体系及20+地方口音,古诗词吟诵也能精准转写。测试显示,典型方言场景字错误率(CER…
