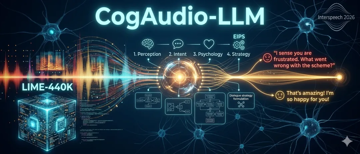
Interspeech 2026|CogAudio-LLM:克服语义主导的认知情感语音大模型

近年来,音频大语言模型(Audio Language Models, ALMs)的出现极大地推动了自然语音对话交互的发展[1][2]。然而,在面对真实场景中强烈的情感陪伴需求时,现有的 ALMs 依然面临深层情感交互的瓶颈。具体而言,模型普…
13 0 0

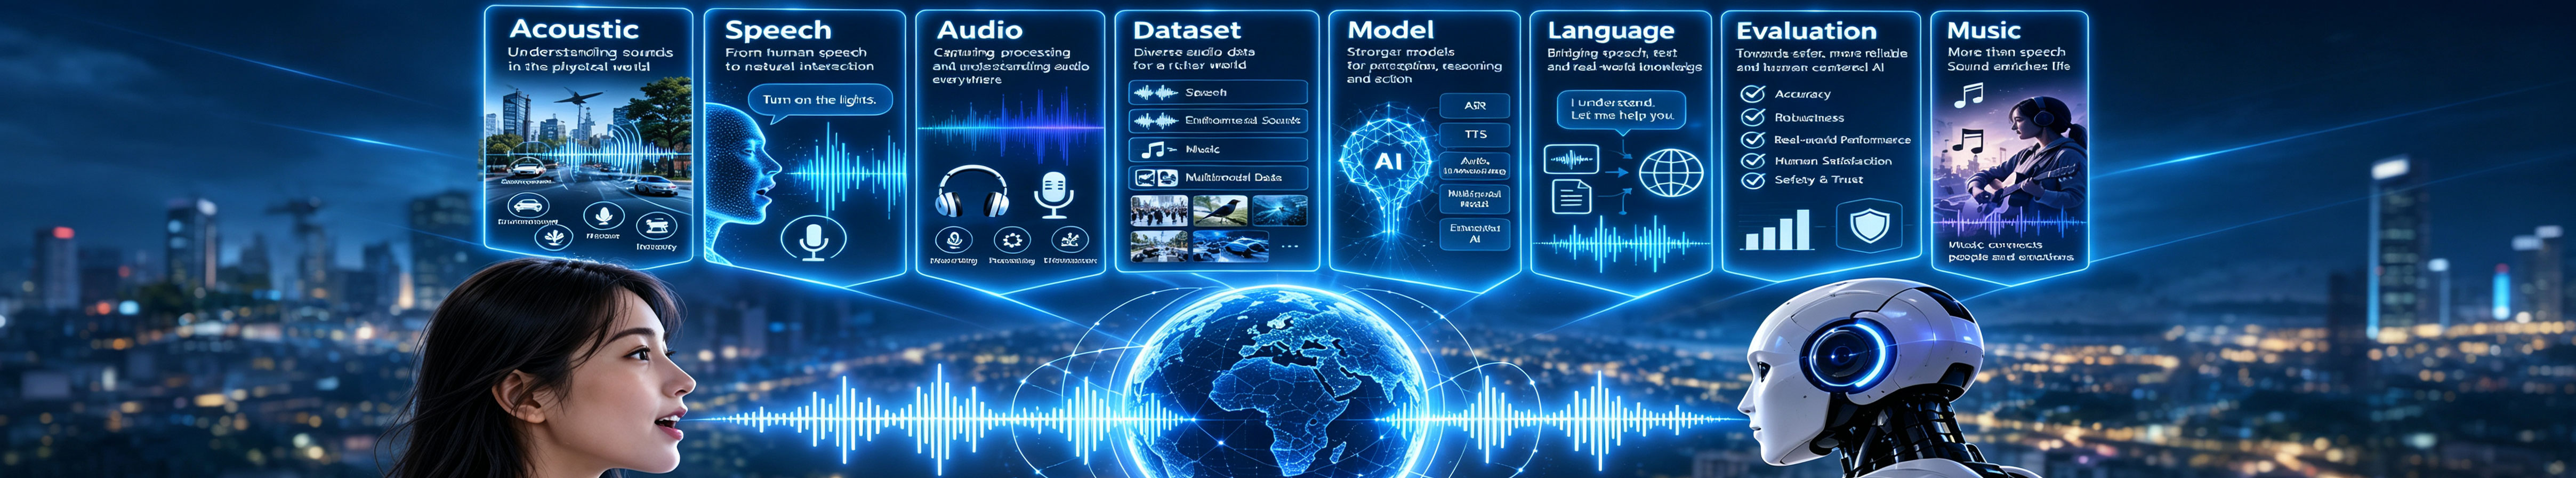
近年来,音频大语言模型(Audio Language Models, ALMs)的出现极大地推动了自然语音对话交互的发展[1][2]。然而,在面对真实场景中强烈的情感陪伴需求时,现有的 ALMs 依然面临深层情感交互的瓶颈。具体而言,模型普…

一 岗位信息 岗位职责: 1. VAD、端点检测、音频前处理、降噪、AGC 算法实现 2. 弱音、振动传感器信号特征提取、基础识别算法开发 3. 轻量模型 / 传统算法在 MCU/RTOS/Linux 移植、定点量化优化 4. 控制内存、实…
本期分享杭州电子科技大学智能语音课题组被语音信号处理领域旗舰会议Interspeech 2026录用的4篇论文,涵盖了神经形态语音增强、用户自定义关键词检测、生成式语音增强以及多任务语音理解测评四个主题。 1. Neuromorphic S…
一 岗位信息 岗位职责: 1. 弱音 ASR 整体技术路线:个体化适配、跨用户 / 文本泛化 2. ASR 训练、微调、迭代、效果指标优化 3. 弱音、低信噪比、病理语音失败样本归因分析 4. 定义语料采集标准、划分训练 / 验证 / 测试…
近几年 TTS 发展极快,而我的技术直觉还停留在 FastSpeech 阶段。最近项目重新需要用到 TTS,我便选取了一些近期在资料、仓库和讨论中反复出现,且本地相对容易接入的模型,做了一次面向实际使用的梳理和评测。 需要说明的是,这不是传…
以下文章来自:南京大学音频声学实验室(NJU-AALab) ICASSP(International Conference on Acoustics, Speech, and Signal Processing)是由IEEE信号处理学会主办…
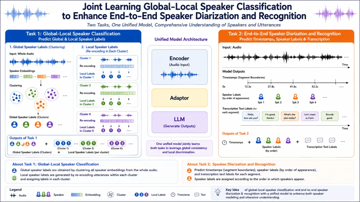
当前,大音频语言模型(LALM)在端到端说话人日志与识别任务中展现出优异性能。但受大规模对话语料稀缺、缺少显式说话人表征优化机制限制,模型的说话人区分能力仍存在短板。现有提升大音频语言模型说话人精度的主流方法,无论是引入额外编码器、设计注册…

